R-squared (R2)
The coefficient of determination, denoted \(R^2\) and pronounced “R squared”, typically corresponds the proportion of the variance in the dependent variable (the response) that is explained (i.e., predicted) by the independent variables (the predictors).
It is an “absolute” index of goodness-of-fit, ranging from 0 to 1 (often expressed in percentage), and can be used for model performance assessment or models comparison.
Different types of R2
As models become more complex, the computation of an \(R^2\) becomes increasingly less straightforward.
Currently, depending on the context of the regression model object, one can choose from the following measures supported in performance:
- Bayesian \(R^2\)
- Cox & Snell’s \(R^2\)
- Efron’s \(R^2\)
- Kullback-Leibler \(R^2\)
- LOO-adjusted \(R^2\)
- McFadden’s \(R^2\)
- McKelvey & Zavoinas \(R^2\)
- Nagelkerke’s \(R^2\)
- Nakagawa’s \(R^2\) for mixed models
- Somers’ \(D_
\) rank correlation for binary outcomes - Tjur’s \(R^2\) — coefficient of determination (D)
- Xu’ \(R^2\) (Omega-squared)
- \(R^2\) for models with zero-inflation
TO BE COMPLETED.
Before we begin, let’s first load the package.
R2 for lm
R2 for glm
In the context of a generalized linear model (e.g., a logistic model which outcome is binary), \(R^2\) doesn’t measure the percentage of “explained variance”, as this concept doesn’t apply. However, the \(R^2\) s that have been adapted for GLMs have retained the name of “R2”, mostly because of the similar properties (the range, the sensitivity, and the interpretation as the amount of explanatory power).
R2 for Mixed Models
Marginal vs. Conditional R2
For mixed models, performance will return two different \(R^2\) s:
- The conditional \(R^2\)
- The marginal \(R^2\)
The marginal \(R^2\) considers only the variance of the fixed effects (without the random effects), while the conditional \(R^2\) takes both the fixed and random effects into account (i.e., the total model).
Note that r2 functions only return the \(R^2\) values. We would encourage users to instead always use the model_performance function to get a more comprehensive set of indices of model fit.
But, in the current vignette, we would like to exclusively focus on this family of functions and will only talk about this measure.
R2 for Bayesian Models
As discussed above, for mixed-effects models, there will be two components associated with \(R^2\) .
Let’s look at another regression analysis carried out with BayesFactor package.
Comparing change in R2 using Cohen’s f
Cohen’s \(f\) (of ANOVA fame) can be used as a measure of effect size in the context of sequential multiple regression (i.e., nested models). That is, when comparing two models, we can examine the ratio between the increase in \(R^2\) and the unexplained variance:
If you want to know more about these indices, you can check out details and references in the functions that compute them here.
Interpretation
If you want to know about how to interpret these \(R^2\) values, see these interpretation guidelines.
Расчет коэффициента детерминации в Microsoft Excel
Одним из показателей, описывающих качество построенной модели в статистике, является коэффициент детерминации (R^2), который ещё называют величиной достоверности аппроксимации. С его помощью можно определить уровень точности прогноза. Давайте узнаем, как можно произвести расчет данного показателя с помощью различных инструментов программы Excel.
Вычисление коэффициента детерминации
В зависимости от уровня коэффициента детерминации, принято разделять модели на три группы:
| 0,8 – 1 | Модель хорошего качества |
| 0,5 – 0,8 | Модель приемлемого качества |
| 0 – 0,5 | Модель плохого качества |
В последнем случае качество модели говорит о невозможности её использования для прогноза.
Выбор способа вычисления указанного значения в Excel зависит от того, является ли регрессия линейной или нет. В первом случае можно использовать функцию КВПИРСОН, а во втором придется воспользоваться специальным инструментом из пакета анализа.
Способ 1: вычисление коэффициента детерминации при линейной функции
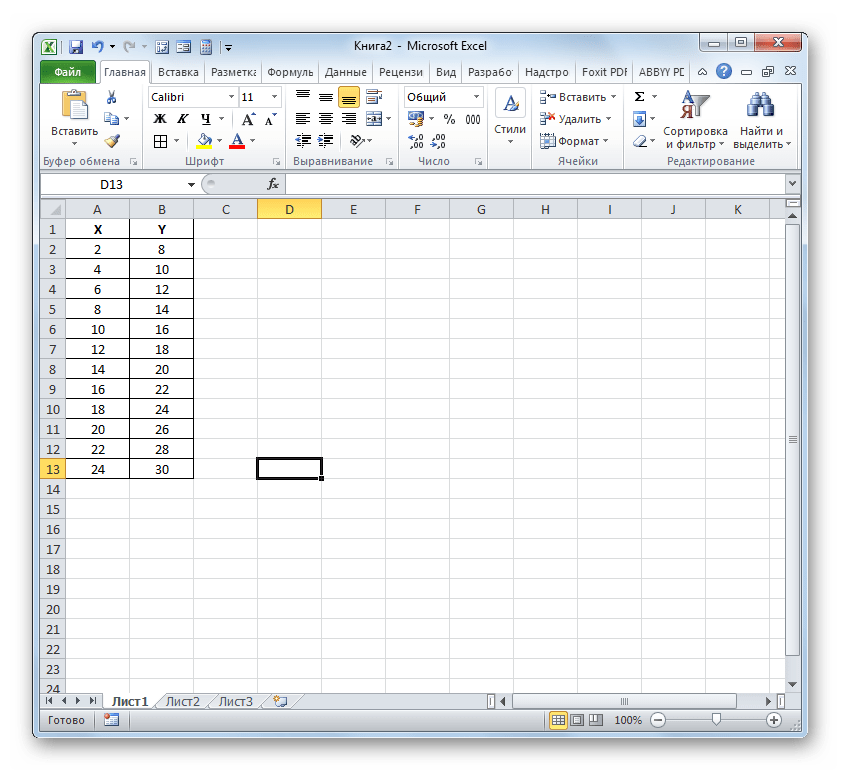
Прежде всего, выясним, как найти коэффициент детерминации при линейной функции. В этом случае данный показатель будет равняться квадрату коэффициента корреляции. Произведем его расчет с помощью встроенной функции Excel на примере конкретной таблицы, которая приведена ниже.
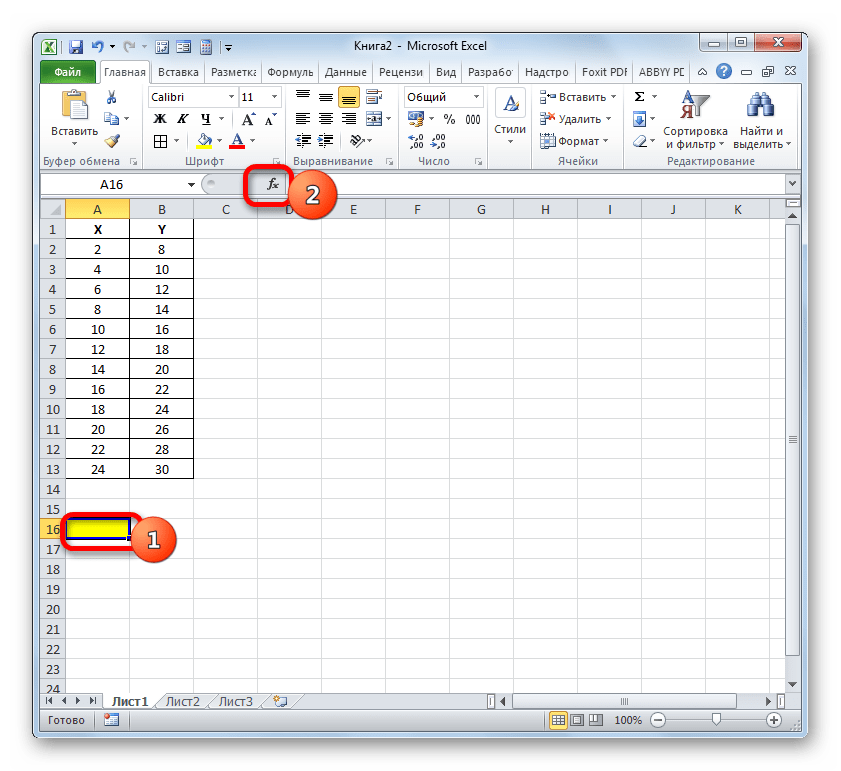
- Выделяем ячейку, где будет произведен вывод коэффициента детерминации после его расчета, и щелкаем по пиктограмме «Вставить функцию».
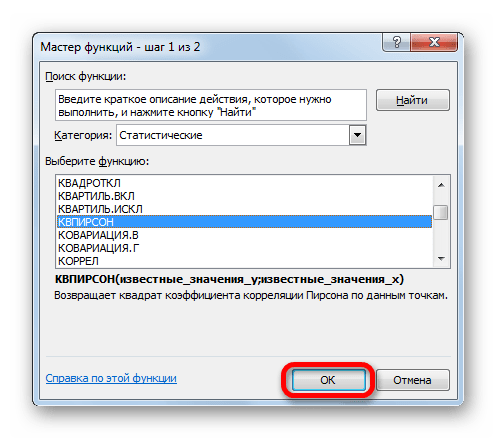
- Запускается Мастер функций. Перемещаемся в его категорию «Статистические» и отмечаем наименование «КВПИРСОН». Далее клацаем по кнопке «OK».
- Происходит запуск окна аргументов функции КВПИРСОН. Данный оператор из статистической группы предназначен для вычисления квадрата коэффициента корреляции функции Пирсона, то есть, линейной функции. А как мы помним, при линейной функции коэффициент детерминации как раз равен квадрату коэффициента корреляции.
Синтаксис этого оператора такой:
Таким образом, функция имеет два оператора, один из которых представляет собой перечень значений функции, а второй – аргументов. Операторы могут быть представлены, как непосредственно в виде значений, перечисленных через точку с запятой (;), так и в виде ссылок на диапазоны, где они расположены. Именно последний вариант и будет использован нами в данном примере.
Устанавливаем курсор в поле «Известные значения y». Выполняем зажим левой кнопки мышки и производим выделение содержимого столбца «Y» таблицы. Как видим, адрес указанного массива данных тут же отображается в окне.
Аналогичным образом заполняем поле «Известные значения x». Ставим курсор в данное поле, но на этот раз выделяем значения столбца «X».
Способ 2: вычисление коэффициента детерминации в нелинейных функциях
Но указанный выше вариант расчета искомого значения можно применять только к линейным функциям. Что же делать, чтобы произвести его расчет в нелинейной функции? В Экселе имеется и такая возможность. Её можно осуществить с помощью инструмента «Регрессия», который является составной частью пакета «Анализ данных».
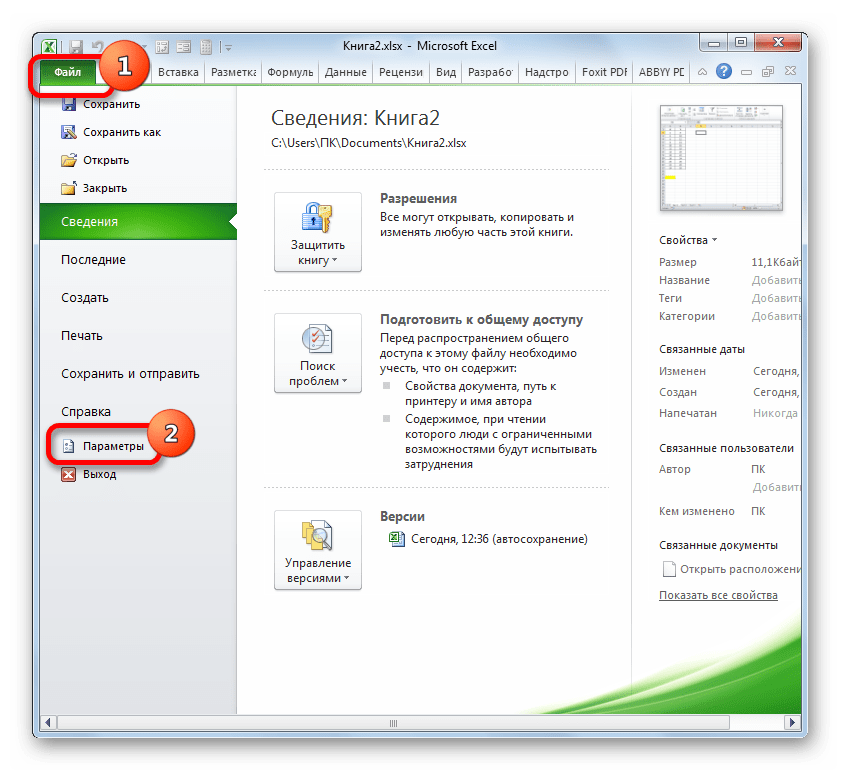
- Но прежде, чем воспользоваться указанным инструментом, следует активировать сам «Пакет анализа», который по умолчанию в Экселе отключен. Перемещаемся во вкладку «Файл», а затем переходим по пункту «Параметры».
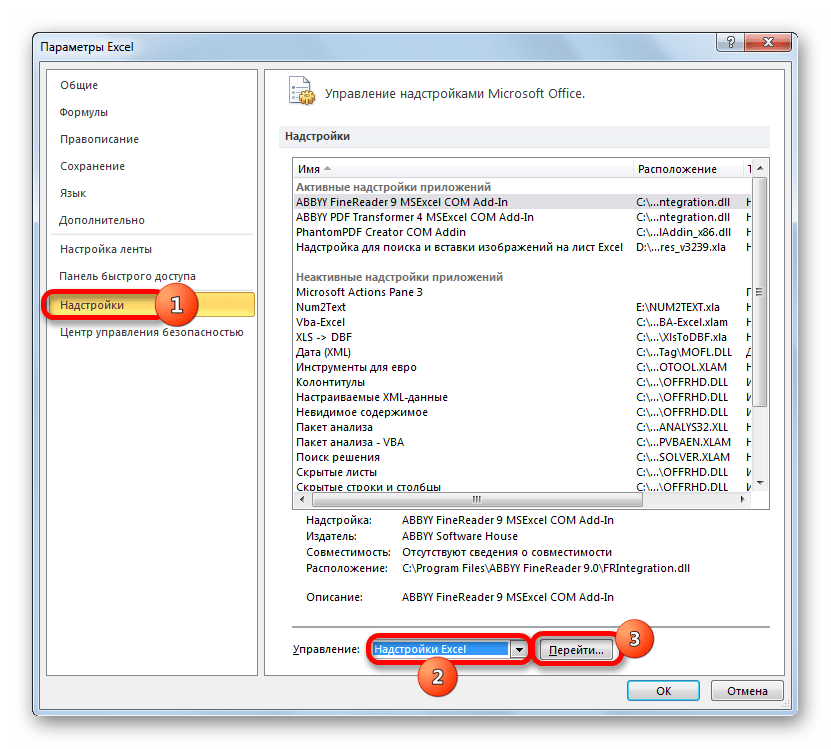
- В открывшемся окне производим перемещение в раздел «Надстройки» при помощи навигации по левому вертикальному меню. В нижней части правой области окна располагается поле «Управление». Из списка доступных там подразделов выбираем наименование «Надстройки Excel…», а затем щелкаем по кнопке «Перейти…», расположенной справа от поля.
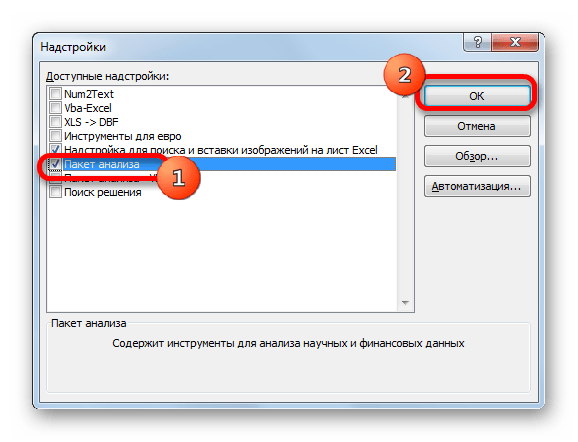
- Производится запуск окна надстроек. В центральной его части расположен список доступных надстроек. Устанавливаем флажок около позиции «Пакет анализа». Вслед за этим требуется щелкнуть по кнопке «OK» в правой части интерфейса окна.
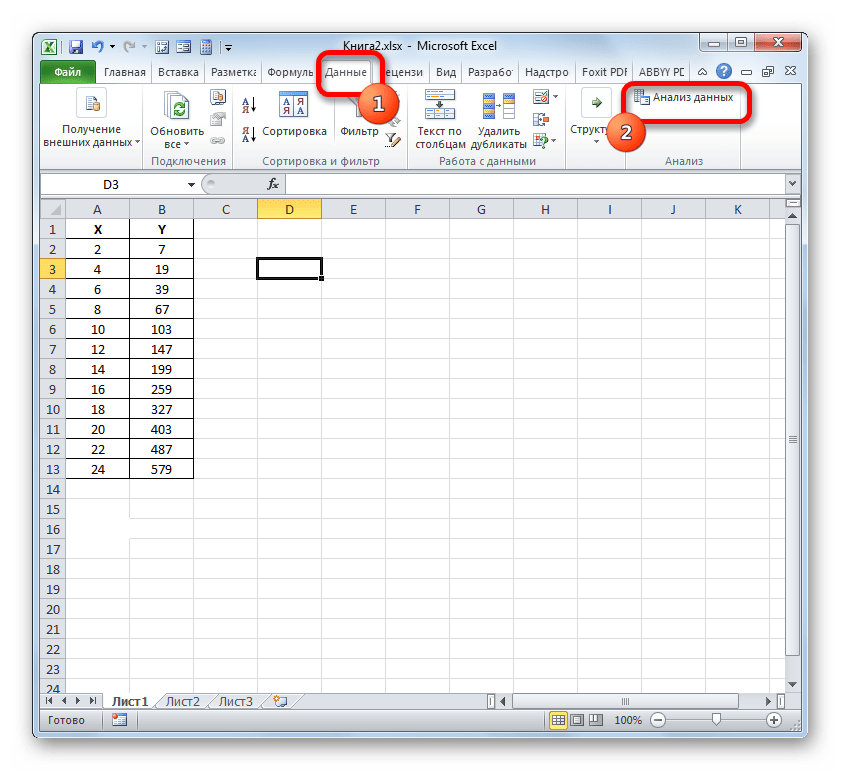
- Пакет инструментов «Анализ данных» в текущем экземпляре Excel будет активирован. Доступ к нему располагается на ленте во вкладке «Данные». Перемещаемся в указанную вкладку и клацаем по кнопке «Анализ данных» в группе настроек «Анализ».
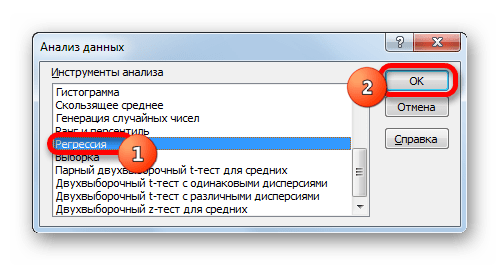
- Активируется окошко «Анализ данных» со списком профильных инструментов обработки информации. Выделяем из этого перечня пункт «Регрессия» и клацаем по кнопке «OK».
- Затем открывается окно инструмента «Регрессия». Первый блок настроек – «Входные данные». Тут в двух полях нужно указать адреса диапазонов, где находятся значения аргумента и функции. Ставим курсор в поле «Входной интервал Y» и выделяем на листе содержимое колонки «Y». После того, как адрес массива отобразился в окне «Регрессия», ставим курсор в поле «Входной интервал Y» и точно таким же образом выделяем ячейки столбца «X».
Около параметров «Метка» и «Константа-ноль» флажки не ставим. Флажок можно установить около параметра «Уровень надежности» и в поле напротив указать желаемую величину соответствующего показателя (по умолчанию 95%).
В группе «Параметры вывода» нужно указать, в какой области будет отображаться результат вычисления. Существует три варианта:
- Область на текущем листе;
- Другой лист;
- Другая книга (новый файл).
Остановим свой выбор на первом варианте, чтобы исходные данные и результат размещались на одном рабочем листе. Ставим переключатель около параметра «Выходной интервал». В поле напротив данного пункта ставим курсор. Щелкаем левой кнопкой мыши по пустому элементу на листе, который призван стать левой верхней ячейкой таблицы вывода итогов расчета. Адрес данного элемента должен высветиться в поле окна «Регрессия».
Способ 3: коэффициент детерминации для линии тренда
Кроме указанных выше вариантов, коэффициент детерминации можно отобразить непосредственно для линии тренда в графике, построенном на листе Excel. Выясним, как это можно сделать на конкретном примере.
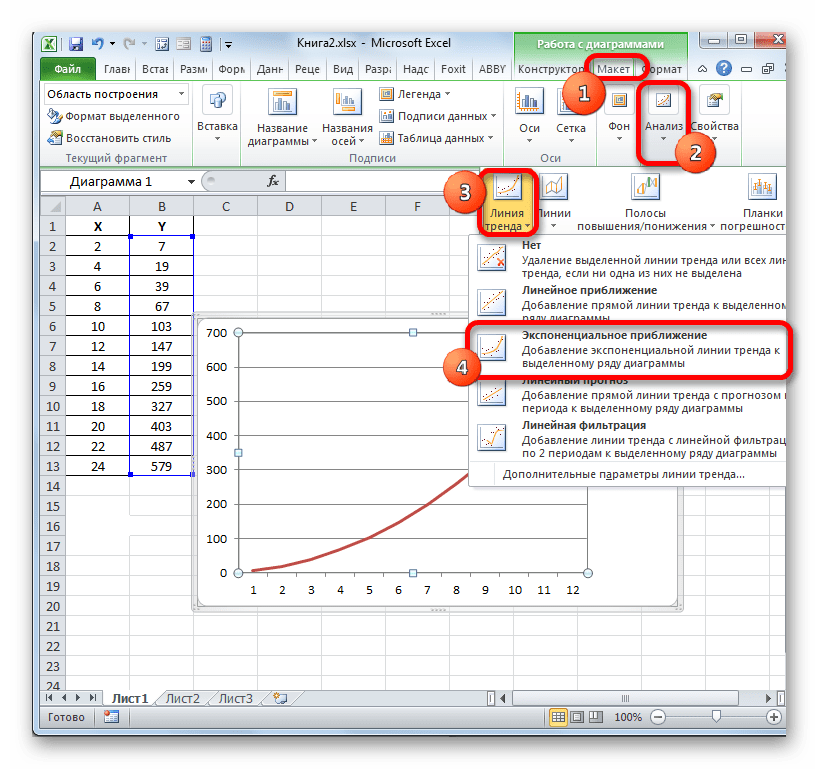
- Мы имеем график, построенный на основе таблицы аргументов и значений функции, которая была использована для предыдущего примера. Произведем построение к нему линии тренда. Кликаем по любому месту области построения, на которой размещен график, левой кнопкой мыши. При этом на ленте появляется дополнительный набор вкладок – «Работа с диаграммами». Переходим во вкладку «Макет». Клацаем по кнопке «Линия тренда», которая размещена в блоке инструментов «Анализ». Появляется меню с выбором типа линии тренда. Останавливаем выбор на том типе, который соответствует конкретной задаче. Давайте для нашего примера выберем вариант «Экспоненциальное приближение».
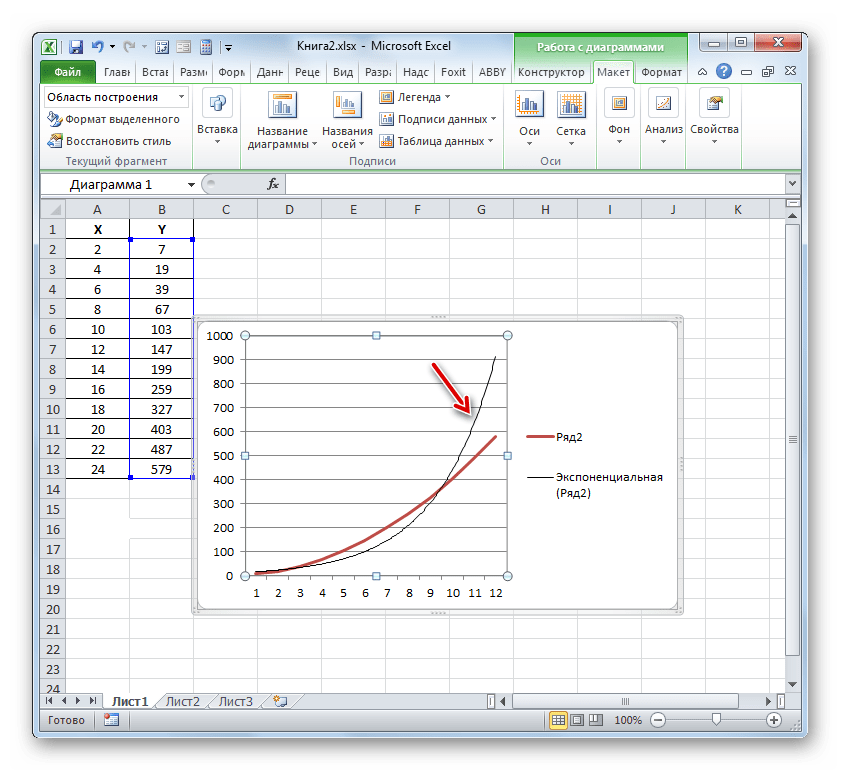
- Эксель строит прямо на плоскости построения графика линию тренда в виде дополнительной черной кривой.
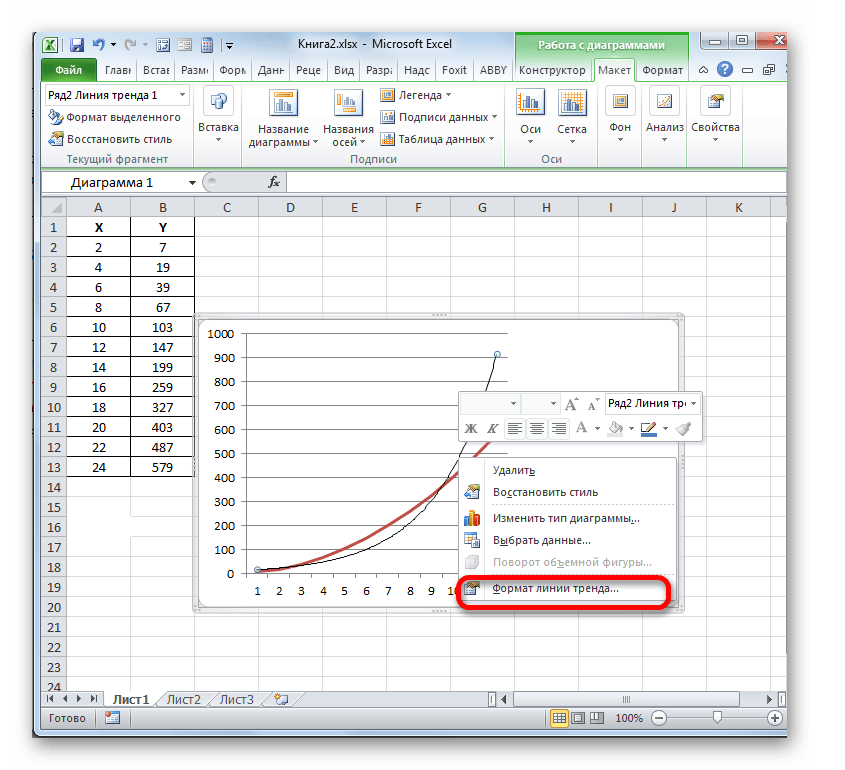
- Теперь нашей задачей является отобразить собственно коэффициент детерминации. Кликаем правой кнопкой мыши по линии тренда. Активируется контекстное меню. Останавливаем выбор в нем на пункте «Формат линии тренда…».
Например, для нашего случая опытным путем удалось установить, что самый высокий уровень достоверности имеет полиномиальный тип линии тренда второй степени. Коэффициент детерминации в данном случае равен 1. Это говорит о том, что указанная модель абсолютно достоверная, что означает полное исключение погрешностей.
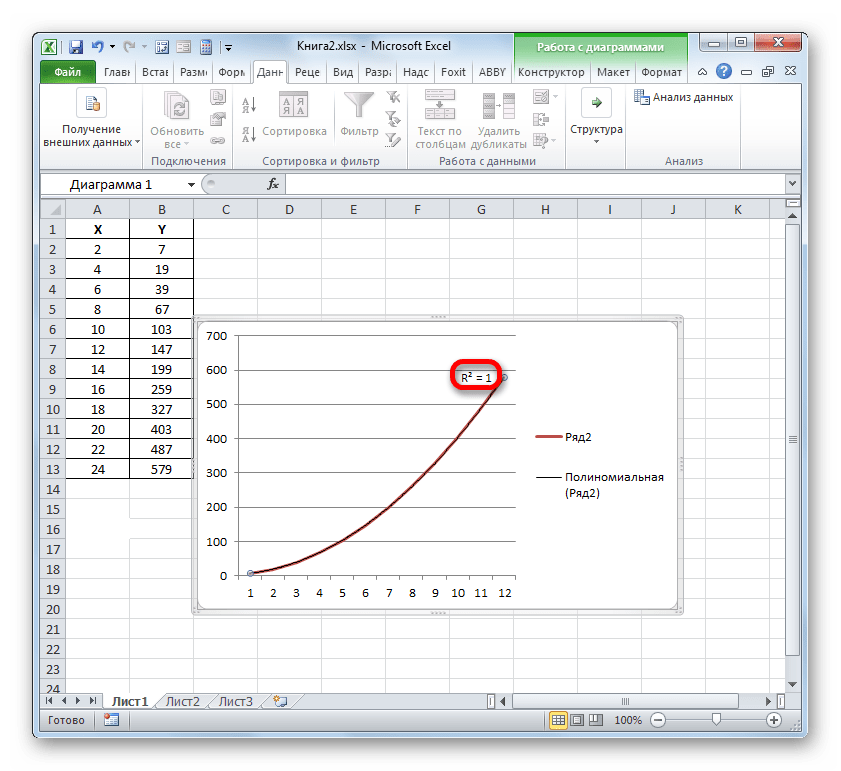
В Экселе существуют два основных варианта вычисления коэффициента детерминации: использование оператора КВПИРСОН и применение инструмента «Регрессия» из пакета инструментов «Анализ данных». При этом первый из этих вариантов предназначен для использования только в процессе обработки линейной функции, а другой вариант можно использовать практически во всех ситуациях. Кроме того, существует возможность отображения коэффициента детерминации для линии трендов графиков в качестве величины достоверности аппроксимации. С помощью данного показателя имеется возможность определить тип линии тренда, который располагает самым высоким уровнем достоверности для конкретной функции.
R-квадрат

Как понять, насколько точно линейная модель дала предсказание? Для этого существует коэффициент детерминации или, как его чаще называют, R².
Формула, по которой вычисляется R² для линейной модели представляет собой единицу минус отношение суммы квадратов остатков регрессии (sum of squares of residuals) к общей сумме квадратов остатков (total sum of squares):
В этой формуле в числителе стоит сумма квадратов остатков регрессии SSres (sum of squares of residuals), то есть сумма квадратов разностей между правильным ответом yᵢ и предсказанным ответом ŷᵢ :
а в знаменателе — общая сумма квадратов остатков SStot (total sum of squares), то есть сумма квадратов разностей между правильным ответом yᵢ и выборочным средним ȳᵢ :
где выборочное среднее ȳᵢ — это просто среднее арифметическое всех правильных ответов:
Чем ближе к единице значение R², тем точнее модель соответствует данных. В том случае, когда значение R² принимает отрицательное значение, можно говорить о неадекватности модели.
Что такое R² в Excel, и зачем нужен тренд на графике?
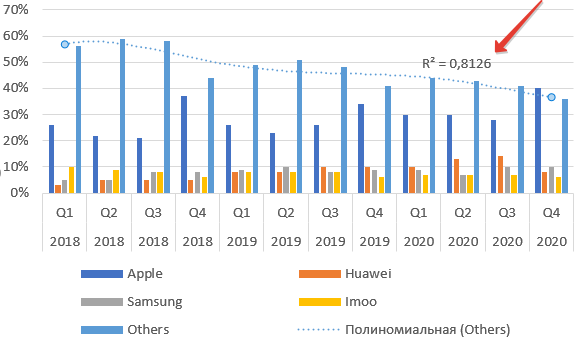
Когда научный руководитель сказал мне о необходимости указать на графике R² (р квадрат), я растерялся. В тот момент я не знал о трендах в диаграммах и графиках Excel. Этот материал поможет сориентироваться начинающим.
Что такое R² в Экселе
Для примера возьмем данные о продажах умных часов по брендам. Саму таблицу и график можно найти по этой ссылке на сайте CounterPointResearch. Там много подобной информации.
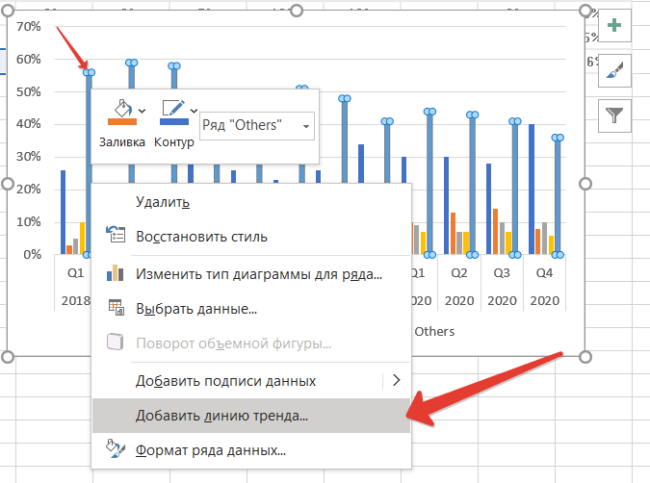
Выделяем диапазон данных и добавляем диаграмму. Теперь наводим мышь на столбцы бренда Others — «остальные», нажимаем правую клавишу мыши. Выбираем пункт Добавить линию тренда.
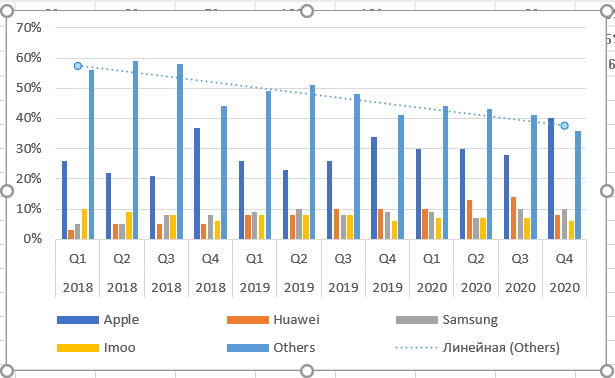
По умолчанию тренд линейный. Чуть позднее расскажу, как выбрать иную функцию, и стоит ли это делать. Теперь подводим курсор мыши к тренду и снова нажимаем правую кнопку.
Добавляем на график R².
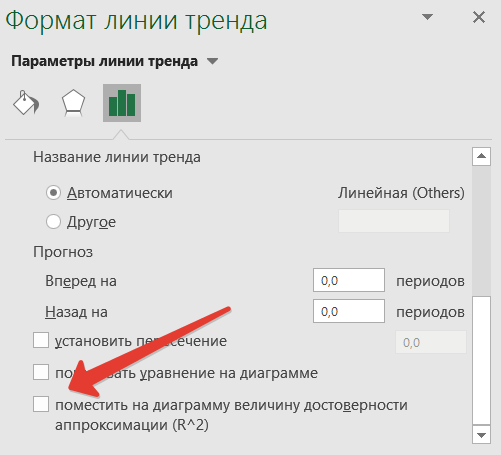
Как видим из названия пункта, это величина достоверности апроксимации. Максимальное значение параметра Р-квадрат единица. Но получить ее можно только на специально подогнанных данных в реальной жизни приемлемое значение 0,8-0,9. В нашем случае — 0,78, что неплохо.
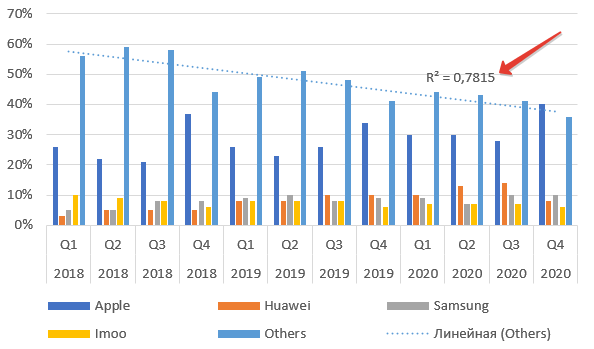
Стоит ли добиваться максимального значения R²
Улучшить достоверность апроксимации можно меняя вид кривой. Это можно сделать в открывающемся справа окошке Формат линии тренда.
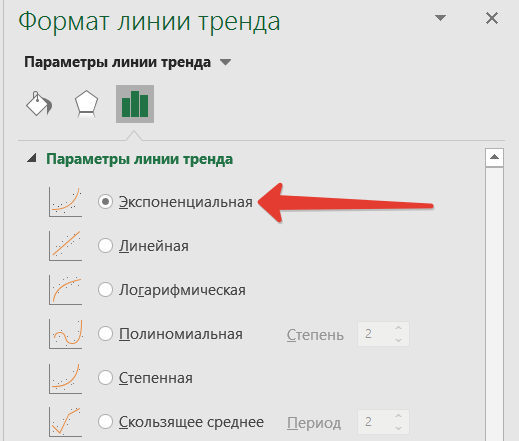
Если использовать полиноминальную функцию, то апроксимацию можно улучшить значительно. Но вот смысла это не имеет. Экономические показатели обычно укладываются в линейный (рост/падение) или экспоненциальный тренд. Экспоненциально, например, растет число клиентов быстрорастущей фирмы.
Выбор полиноминальной функции может и улучшит показатель достоверности, а вот прогноз сделает менее точным.
Как использовать тренд для прогноза
Кроме определения общего положения дел (рост/снижение), тренд может предсказать значения показателей в будущем. Это делается в окошке Формата линии тренда.
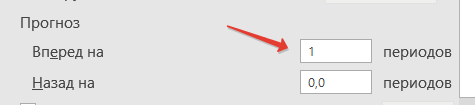
Попробуем предсказать продажи умных часов в первом квартале 2021 году и сравним их с фактом. Добавим два линейных тренда для Apple и Остальных.
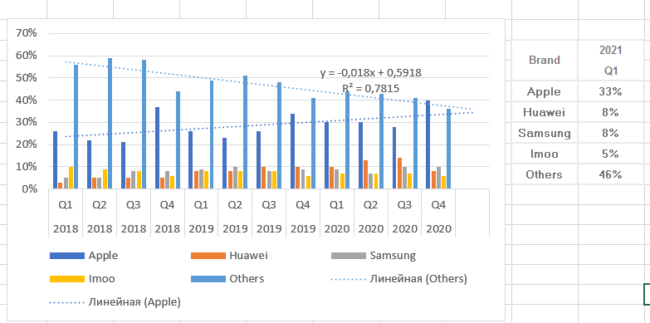
Как видим, по яблочным часа прогноз построен верно, по остальным функция прогнозирует значение около 35%, а в реальности 46%. Возможно, это связано с выходом новых игроков на рынок или снижением доли Huawei. Мы имеем дело с относительными показателями (доля), а не с натуральными. Кстати, полиноминальный прогноз для категории Остальные дал бы еще менее точный прогноз, хотя R² и выше, что подтверждает необходимость осторожно выбирать функцию.
Почитайте и другие статьи про работу с таблицами Excel на нашем сайте. Например, у нас есть полезный материал об условном оформлении ячеек в таблице.