Работа с проектом: этапы, особенности и артефакты
Начинаем серию статей для быстрого погружения в проджект-менеджмент. Весь курс в видеоформате можно бесплатно пройти на GeekBrains. А здесь первый урок в текстовом виде — для тех, кому удобнее читать.
Этапы проекта
Любой проект состоит из четырёх этапов: инициализации, планирования, реализации и завершения. Рассмотрим каждый подробнее.
Инициализация. Заказчик приходит к проджект-менеджеру с запросом. Менеджер анализирует бизнес-идею (определяет содержание и длительность проекта), разрабатывает проектное задание и выполняет стратегическое планирование.
Планирование. Проджект-менеджер определяет, из каких специалистов будет состоять команда, каковы объёмы проекта, его этапы и контрольные точки для сверки с заказчиком. Также выявляет возможные риски и рассчитывает ресурсы.
Реализация. Проджект помогает команде создать конечный продукт или его часть — для этого отслеживает и контролирует каждый из этапов, решает проблемы, информирует заказчика о ходе проекта и управляет изменениями.
Завершение. Проджект-менеджер сдаёт продукт заказчику, оценивает уровень удовлетворённости клиента и приобретённый опыт. Фиксирует успехи, неудачи и их причины, чтобы стать эффективнее и избежать негативного опыта в будущем.
Проектные артефакты
Артефакты проекта — это физические носители информации, которые подтверждают договорённости и позволяют всем членам команды следить за ходом проекта. Например, договор, коммерческое предложение, техническое задание, сопроводительные документы, исполняемые файлы, исходные тексты, веб-страницы, файлы с данными и справочной информацией. При этом универсального набора артефактов не существует — на каждом проекте он свой.
Рассмотрим, как распределяются артефакты на каждом из этапов проекта. При этом от проекта к проекту набор будет немного разным.
Инициализация: техническое задание, коммерческое предложение, договор и приложение к нему, дополнительное соглашение.
Планирование: план проекта, дорожная карта, точки сверки и ресурсный план.
Реализация: акт сдачи-приёмки работ, замечания и доработки.
Завершение: инструкция по работе, обучение, акт сдачи-приёмки работ.
Так могут выглядеть основные артефакты по IT-проекту:
- Техническое задание (цели, требования, техническая документация).
- Паспорт проекта (свод данных, участники и их зоны ответственности).
- Макеты и дизайн.
- Результаты исследований.
- Итоги встреч и других коммуникаций.
- Список задач.
- Итоги проекта (доступы, документация, права).
- Планы на будущее (доработки).
Сбор артефактов
Проджект-менеджер собирает артефакты проекта во время согласования требований с заказчиком и уточнения деталей — лучше показаться дотошным и избежать недоразумений, чем поскромничать и недопонять клиента.
Проджект обсуждает требования с командой, чтобы быть уверенным, что каждый понял свою задачу и выполнит работу корректно. Это ещё один этап, на котором формируются артефакты проекта.
Проджект-менеджер согласовывает результаты с конечными пользователями — это подтверждает, что команда делает именно то, что нужно заказчику.
Результаты каждой встречи фиксируются — это позволяет избегать многих неприятных ситуаций. Например, если заказчик попросит разработать новую фичу, которая не была прописана в изначальном техническом задании, — будет возможность обсудить условия дополнительной оплаты и новые сроки. Клиент не сможет сказать, что он говорил о ней ранее и вы обещали реализовать её в рамках стандартной оплаты. Также это не позволит заказчику выставить одни требования, а затем сказать: «Я видел это совсем иначе». У вас всё зафиксировано!
После встречи проджект рассылает её итоги всем участникам проекта, а клиента просит подтвердить, что он тоже ознакомился с ними. Если он не отвечает, то менеджер не стесняется напомнить о письме.
Виды артефактов
Артефакты делятся на формальные и неформальные.
Формальные — обязательные, прописанные в договоре, на которых стоят реквизиты заказчика и исполнителя. Также к формальным артефактам относится документация и элементы, которые указаны в официальных документах. Если в договоре написано, что исполнитель обязан предоставить результаты исследования, то они будут формальным артефактом.
Неформальные артефакты — вся остальная информация: итоги переписок, сообщения в мессенджерах, записи с флипчарта, на котором команда фиксирует ход проекта, стикеры с канбан-доски и даже матрица RACI.
Виды заказчиков
Заказчиков принято разделять по двум принципам. Первый — по традиционному объёму документации, который необходимо вести по проекту. Второй — с точки зрения того, как происходит процесс взаимодействия до запуска проекта. В этой классификации выделяют четыре вида заказчиков:
- Государственный заказчик (управление, больница, школа).
- Близкий к государственной сфере.
- Бизнес-заказчик.
- Стартап (небольшой бизнес-заказчик).
Есть и другая категоризация заказчиков — по ней они могут быть внутренними и внешними. Внутренний заказчик — это смежный отдел. Если GeekBrains закажет IT-решение у отдела разработки, входящего в Mail.ru Group, то станет для него внутренним заказчиком — всё будет происходить в рамках одной компании. Если GeekBrains поставит задачу разработать IT-решение стороннему подрядчику, то выступит для него внешним заказчиком.
Зона ответственности заказчика
Работая в любом проекте, нужно понимать, к кому и с каким вопросом обращаться: что может решить заказчик, что руководитель, а когда стоит получить больше информации от команды. Чтобы не растеряться в самый неподходящий момент, на старте нужно распределить зоны ответственности. Один из классических инструментов для этого — матрица RACI.
Матрица RACI — это таблица, в которой проджект-менеджер по горизонтали вписывает зоны ответственности, а по вертикали — исполнителей и другие действующие лица на проекте (заказчиков, членов команды, подрядчиков). Этот инструмент помогает распределить ответственность ещё на этапах инициализации и планирования проекта.
В матрице выделяется четыре зоны ответственности: R — responsible (исполняет), A — accountable (несёт ответственность) C — consult before doing (консультирует до исполнения), I — inform after doing (оповещает после исполнения). Рассмотрим это на примере.
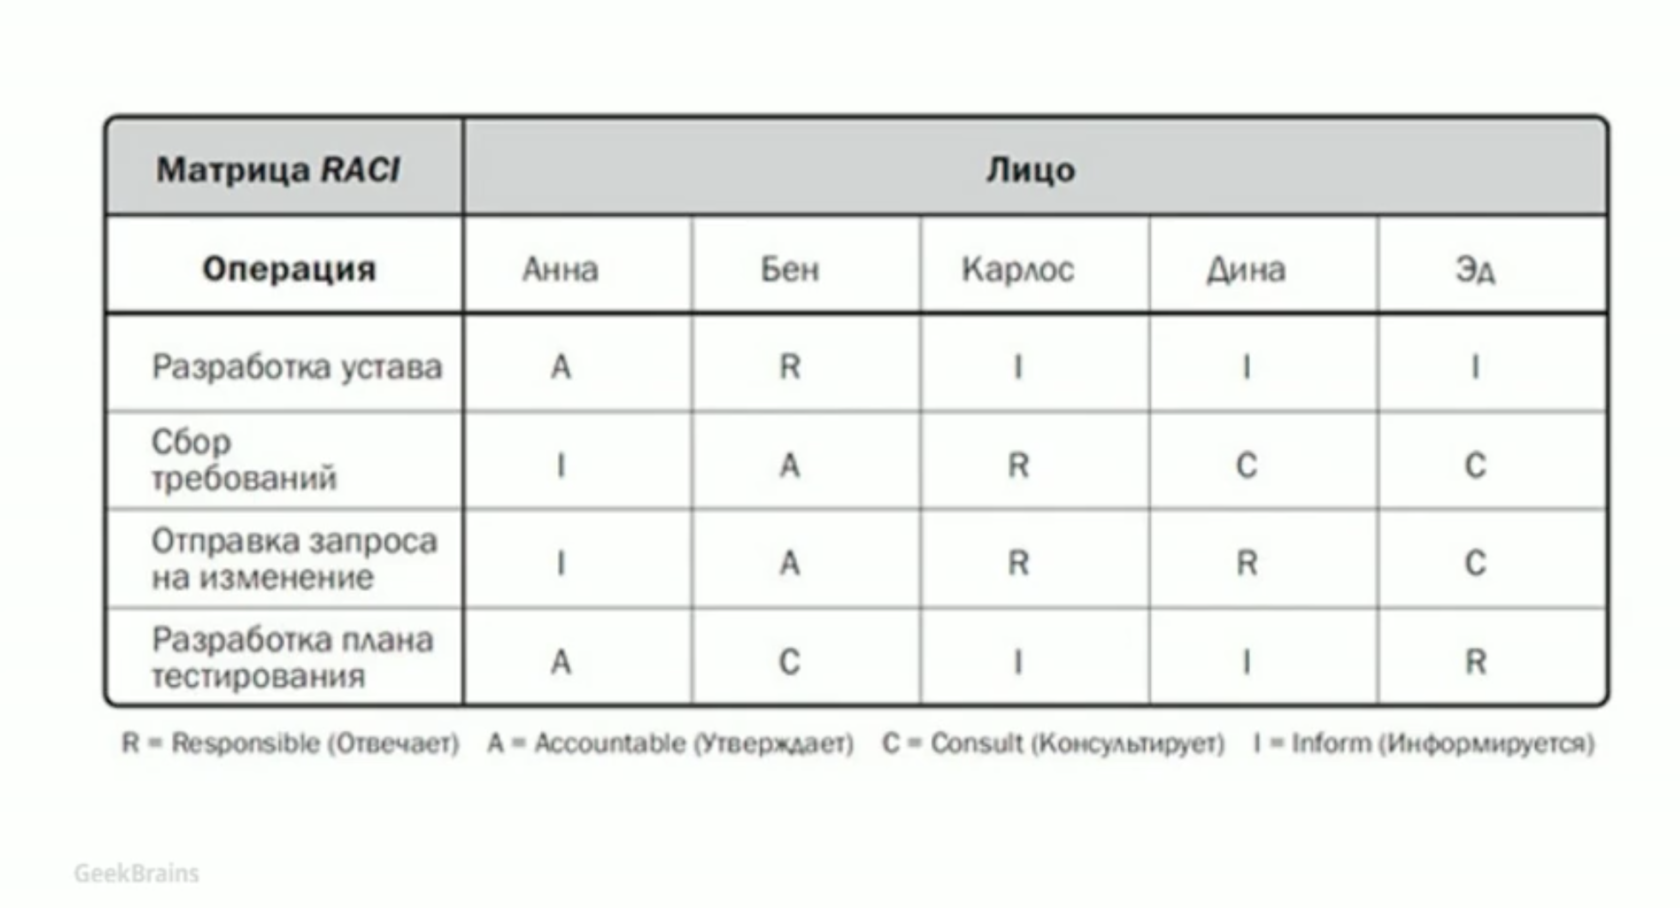
По горизонтали прописаны зоны ответственности, а по вертикали — действующие лица. Анна разрабатывает устав, а Бен несёт ответственность за выполнение этой задачи. Если у кого-то из членов команды появится вопрос про устав, он сразу поймёт, к кому обратиться.
Чтобы составить матрицу RACI, нужно выполнить следующие шаги:
- Составить список процессов или зон ответственности.
- Выделить функциональные роли.
- Назначить встречу с заказчиком и командой.
- Описать матрицу.
- Определить несоответствия (опционально).
- Проконтролировать выполнение назначенных ролей.
При этом важно соблюдать основные принципы:
- A должен быть в каждой задаче только один.
- R должен быть в каждой задаче, и их может быть несколько.
Удержать все эти вещи в голове непросто, но благодаря практике можно стать эффективным проджект-менеджером. Попробуйте начать свой путь в профессии с бесплатного курса GeekBrains. Желаем удачи!
От разработки до релиза

В разработке любого приложения все начинается с исходного кода, а заканчивается приложением, которое доступное пользователю. В зависимости от типа приложения (веб приложение, мобильное или десктопное) процесс преобразования исходного кода в финальных продукт может отличаться. Назовем этот процесс – процесс релиза.
Процесс релиза может отличаться в зависимости от типа приложения, но этапы остаются всегда одни и те же.
Исходный код – файлы, которые вы создаете и в которых пишете код. Они обычно хранятся в вашем VCS (git, svn, mercurial, и др)
Артефактом будем называть результат сборки исходных кодов. Это может быть бинарный файл или собранный js bundle. Это тот ресурс, который будет использовать пользователь.
Этапы релиза
- Тестирование исходников
- Сборка артефакта
- Тестирование артефакта
- Сохранение артефакта
- Развертывание артефакта
Тестирование исходников
На этом этапе мы работаем с исходным кодом. Мы проверяем его юнит тестами, интеграционными тестами, запускаем линтеры для анализа форматирования и статического анализа кода.
Все что мы можем проверить без сборки – мы проверяем тут. Это обычно быстрые проверки.
- Юнит тесты
- Интеграционные тесты
- Статистические анализаторы кода (линтеры, статические проверки типов)
- Просчет процента покрытия тестами
Сборка артефакта
На этапе сборки мы собираем наш проект. Это может быть компиляция мобильного приложенияили сборка js бандла для фронтенд проектов. В общем, тут мы собираем финальную версию артефакта, который мы в последствии доставим пользователю. Сборка Docker контейнера – это как раз для этого этапа. Ведь именно этот Docker контейнер будет работать на наших production и dev средах.
Требование к артефакту
Приложение должно удовлетворять 12 факторам. Для нас критично следующее:
- Разделение кода и конфигурации
Вы должны иметь возможность развернуть ваш артефакт как для production использования, так и для beta или alpha тестирования. И если вам, например, потребуется поменять настройки доступа к базе данных или параметры доступа к АПИ – вы должны это уметь делать через внешний конфигурационный файл.
Этот пункт важен для следующего этапа. Мы будет запускать автоматическое приемочное тестирование. Обычно, для приёмочного тестирования используется dev или beta среда, а в процессе развертывания на production мы будем использовать другую конфигурацию, без повторной сборки.
Лакмусовой бумажкой того, правильно ли разделены конфигурация и код приложения, является факт того, что кодовая база приложения может быть в любой момент открыта в свободный доступ без компрометации каких-либо приватных данных.
Если вы чувствуете себя неуверенно в этом моменте – пожалуйста, углубитесь в этот материал: https://12factor.net/ru/config
Тестирование артефакта
После того, как мы собрали артефакт – мы его можем потестировать. Как вы помните, юнит и интеграционные тесты мы уже запускали, значит теперь время для приемочного (acceptance) тестирования.
Для веб приложения – это selenium тесты. Чтобы их запустить мы должны, например запустить наш Docker контейнер, и прогнать эти тесты на нем. Также на этом этапе может проводится тестирование в визуальный регрессий – сравниваем скриншоты предыдущей и текущей версий и находим отличия.
Для мобильного приложения – Appium тесты. Мы тестируем наш .ipa или .apk файл с помощью приемочных тестов – симулируем работу пользователей с нашим приложением.
Сохранение артефакта
После того как артефакт протестирован – мы его сохраняем. Обычно на этом шаге мы уверенны, кто наше приложение работоспособное по тем тест кейсам, на которые у нас есть автотесты.
В зависимости от требований проекта мы можем сохранять, а можем и не сохранять артефакты, которые не прошли успешно этап тестирования артефакта. Для процессов сборки, где решения должен принимать человек – например, как в тестировании визуальной регрессии, человек принимает решение о том, правильные ли изменения зафиксированы или нет. В этом случае нам нужно сохранять все артефакты, и которые имеют изменения, и которые нет. Чтобы решение мог принять разработчик.
Хранить артефакты можно по-разному: Docker Hub, CDN, просто zip файлы на каком то файловом хранилище. Это не столь важно. Главное точно нужно указать версию и ссылку на коммит (конечно, если вы используете vcs) и чтобы было удобно работать с этим хранилищем на следующем этапе – этапе развертывания.
Между этапом хранения и развертывания может быть еще множество этапов ручного тестирования и одобрения артефакта. Главное, что мы работаем с уже собранным артефактом, который мы частично протестировали и который в последствии будет разворачиваться в среде.
Развертывание артефакта
Для веб проектов – обновление веб сервера
Дл мобильный и десктопных приложений – загрузка в магазин приложений или в любое место распространения приложения (например, отправка издателю для печати дисков :)).
Этот этапе мы работаем с 3 сущностями: среда, куда мы развёртываем, артефакт, который мы развертываем, и конфиг, с помощью которого мы развертываем.
- Где? Среда
- Что? Артефакт
- Как? Конфиг
Артефакт мы загружаем из нашего хранилища. Конфиг хранится в среде развертывания. А сама среда знает как работать с этими 2 сущностями.
Примеры
Kubernetes, Docker, Docker Hub
Система – Kubernetes. У нас есть конфигурация Kubernetes, в которой прописана конфигурация нашего приложения. Для того, чтобы обновить приложение – мы меняем версию Docker контейнера и запускаем команду обновления. Новый артефакт (Docker образ) будет загружен из нашего хранилища (напр, Docker Hub) в нашу среду (Kubernetes) и наш собранный артефакт заработает на нашей среде.
Повторюсь. На этом этапе не должно происходить никакой сборки. Мы только загружаем артефакт из хранилища и запускаем его с конфигом. Наш артефакт уже протестирован. И если мы его будем собирать на этапе развертывания могут быть проблемы с откатыванием на предыдущую версию.
Неудачный пример #1
Веб приложение, git, circle ci, surge
Приложение тестируется на circle ci и в случае успешного прохождения тестов из ветки develop развертывается в на тестовой среде.
Развертывание production среды происходит руками.
Что не так?
Сборка проекта происходит каждый раз перед развертывание production. В случае неудачной версии, когда нужно вернуться на предыдущую версию – нам нужно снова пересобирать артефакт. Результат может отличаться. Например, хеши в названиях файлов, которые используются для обновления кеша будут другие. В некоторых случаях это может привести к проблеме.
Решение: собирать артефакт на CI и выгружать в хранилище. Настроить деплой из хранилища.
Неудачный пример #2
Веб приложение, git, nginx
Простой веб проект. Процесс развертывания выглядит след образом. Программист подключается к веб серверу по ssh, стягивает нужный commit, обновляет зависимости, запускает процесс сборки.
Что не так?
Нельзя быть на 100% уверенным в сборке. Собранная версия не протестированная. Даже если версия работает локально – не факт что сборка прошла корректно на удаленной машине.
Что делать?
Пересмотреть процесс сборки. Разделить сборку и развертывание приложения. Сохранять артефакты сборки в хранилище и использовать их в процессе деплоя.
Выводы
Разделив процесс релиза на этапы вы будете четче понимать весь процесс. Каждый этап имеет свою цель, а также входные данные и результат. Настаивайте ваш процесс грамотно и гладких вам релизов 🙂
Что такое артефакт в разработке ПО?

Артефакт — это любой созданный искусственно элемент программной системы.
К элементам программной системы, а, следовательно, и к артефактам, могут относиться исполняемые файлы, исходные тексты, веб страницы, справочные файлы, сопроводительные документы, файлы с данными, модели и многое другое, являющееся физическим носителем информации. Другими словами, артефактами являются те информационные элементы, которые тем или иным способом используются при работе программной системы и входят в ее состав.
С понятием «компонент» часто ассоциируют компонентное или сборочного программирование, однако это не верно с точки зрения UML. В терминах UML компонентное или сборочное программирование манипулирует артефактами!
Компонент (в UML) — это частью модели, описывающая логическую сущность, которая существует только во время проектирования (design time), хотя в дальнейшем ее можно связать с физической реализацией (артефактом) времени исполнения (run time).
Managing Software Artifacts in DevOps
If you create software, you certainly create a number of software artifacts along the way. Artifacts are a natural byproduct of the software delivery process, and managing them in an efficient and secure way is critical for ensuring the health and reliability of your delivery chain.

This article explains what software artifacts are, why they matter to DevOps teams and how best to approach artifact management as part of a DevOps strategy.
What is a software artifact?
A software artifact is any type of object produced as part of the software delivery process (for example, the Continuous Integration/Continuous (CI/CD) Delivery pipeline ).
Artifacts could be source code, documentation, container images, software licenses or any other type of file or resource that the team generates as it builds software. Indeed, you can think of software artifacts as the “exhaust” of the software delivery process. They are naturally produced as DevOps teams do their job.
Teams typically store artifacts in artifact repositories , which provide a secure, centralized location for managing all of the artifacts that a team creates.
Why are software artifacts important to DevOps?
Software artifacts can exist in any type of application development environment – they are not unique to organizations that have embraced DevOps.
However, artifacts play an especially important role in DevOps, for several reasons:
Reuse of resources
DevOps teams deliver software in repetitive releases. Sometimes, they may need to reuse artifacts from an earlier release cycle to help produce a later one.
For example, a documentation artifact from a previous release may be necessary for identifying known problems with that release so that they can be addressed in the next release. Or, developers may remove some source code from an application, only to discover at a later time that they need to reincorporate the code.
In cases like these, the team can reuse artifacts from earlier release cycles to keep current ones running fast and efficiently.
Team collaboration
DevOps release cycles are composed of a variety of distinct phases, such as development, testing, deployment, and production management. Each step in the process is often “owned” by a different team, which produces different types of artifacts as it does its work. Developers create source code, for example, while the testing team creates binaries, and the IT team generates documentation to keep track of issues that arise in production.
By sharing artifacts across the DevOps organization, it becomes easier for these various teams to collaborate with each other. For instance, developers may want to view documentation created by the IT team in order to discover problems that occurred in production, which the developers can then fix in the next release cycle.
Fast rollbacks
Artifacts are a vital resource in the event that a team needs to perform a rollback, which means reverting an application to an earlier version. DevOps teams typically use rollbacks to address problems that arise within a production environment. By rolling back to an earlier release that is known to be stable, teams can minimize disruptions to users while they work on fixing the root cause of the issue.
In order to perform a rollback, teams need artifacts like container images or binaries from earlier versions of an application. If they don’t have these artifacts on hand, they would have to rebuild the application from scratch. That could take some time, which is a problem when teams need to roll back a deployment immediately in order to correct an issue that is impacting end-users.
Best practices for working with software artifacts in DevOps
At a minimum, simply storing artifacts in a centralized way is a basic step toward ensuring that your DevOps team has access to the artifacts it needs, when it needs them. But teams should also adhere to other best practices that help them make the most of the artifacts they have on hand.
Keep artifacts in sync with metadata
Software artifacts often have metadata associated with them. Metadata is contextual information such as when the artifact was created or which release cycle it was part of.
In some cases, having access to metadata is just as important as having the artifact itself. When managing artifacts, strive to ensure that metadata is reliably stored alongside them, and that even when artifacts are updated or moved, their metadata stays intact.
Share artifacts across the team
As noted above, being able to share artifacts across the DevOps organizations helps different teams to collaborate and coordinate their activities. The best artifact management strategies, then, are ones that allow all team members to access the artifacts they need. You should avoid practices where each team stores its artifacts separately, making it hard for other teams to access them.
Enforce software artifact access controls
Access controls, which govern who can access artifacts, are essential for managing artifacts securely. Although sharing artifacts between teams is often beneficial, some artifacts may be sensitive in nature, and not all teams should always be able to access all artifacts.
If an artifact contains private user data, for instance, it should be stored in such a way that only engineers who have a reason to need that data can access it. Likewise, documentation artifacts may sometimes contain sensitive information that could help an attacker find the weak points within a system or application, which makes it important to set up access controls for documentation.
Retain artifacts appropriately
DevOps teams may need to access artifacts long after the artifacts are created. And even if you don’t think you’ll ever need to use an artifact again, a situation may arise where you do. You never know when you’ll need to review old source code or an application binary to research a security incident, for example.
For this reason, it’s a best practice to establish retention policies that allow you to store artifacts as long as you may reasonably need to access them. Although it’s not always practical, due to storage limitations, to retain every artifact indefinitely, you should set retention policies for different types of artifacts based on the likelihood that you will need them in the future and the cost of storing them. Artifacts that are relatively unimportant, or that consume large amounts of space, may not need to be retained as long as smaller or mission-critical ones.
Get the most out of your software artifacts
Software artifacts are a vital resource for DevOps teams. They help to minimize risks and enhance collaboration and efficiency. That’s why it’s wise to implement a secure, centralized artifact management platform, like JFrog Artifactory , which allows teams to store any type of artifact for as long as they need, while maintaining granular access controls and metadata.