Правило трех сигм
В чем заключается правило трех сигм (3-sigma rule) в статистике
Математическое ожидание — это среднее значение случайной величины. Обозначается как \(\mu\) .
Стандартное или среднеквадратичное отклонение — это наиболее частый показатель рассеивания значений величины относительно математического ожидания. Обозначается символом \(\sigma\) , который произносится как «сигма».
Правило трех сигм заключается в том, что при нормальном распределении практически все значения величины с вероятностью 0,9973 лежат не далее трех сигм в любую сторону от математического ожидания, то есть находятся в диапазоне \(\left[\mu-3\sigma;\;\mu+3\sigma\right]\) .
Осторожно! Если преподаватель обнаружит плагиат в работе, не избежать крупных проблем (вплоть до отчисления). Если нет возможности написать самому, закажите тут.
Приблизительно 99,7% всех значений лежат в пределе трех сигм от математического ожидания, около 95% — в пределах двух сигм, а примерно 68% значений лежат в пределах всего одной сигмы.
Те значения, которые выходят за рамки 3 сигм, принято считать грубыми ошибками. Большое количество таких ошибок может свидетельствовать о том, что распределение на самом деле не является нормальным. В этом заключается практическая польза правила 3 сигм.
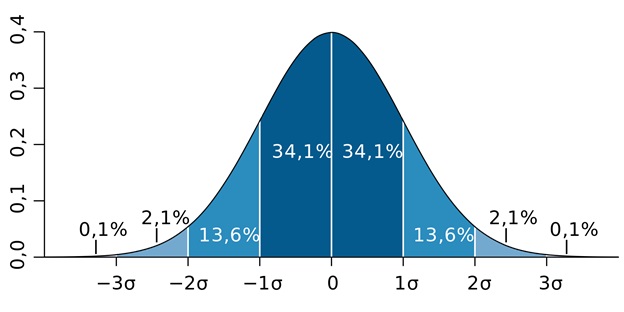
Нормальное распределение случайной величины
Нормальное распределение (распределение Гаусса) — это такое распределение вероятностей, функция плотности которого совпадает с функцией Гаусса.
где \(\mu\) — значение математического ожидания, \(\sigma\) – величина среднеквадратического отклонения, \(\sigma^2\) — дисперсия распределения.
Функция плотности — это функция, которая характеризует сравнительную вероятность реализации определенных значений случайной переменной или переменных.
Иными словами, функция плотности показывает, с какой вероятностью случайное значение будет равно заданному. Чем «выше» значение по оси ординат, тем больше вероятность, что случайное значение будет равно данному по оси абсцисс. Таким образом, на графике нормального распределения наиболее вероятно то значение, которое совпадает с точкой максимума. А те значения, которые находятся в «основании» графика, то есть находятся низко по оси Y, менее вероятны.
Нормальное распределение величины центрировано и нормировано.
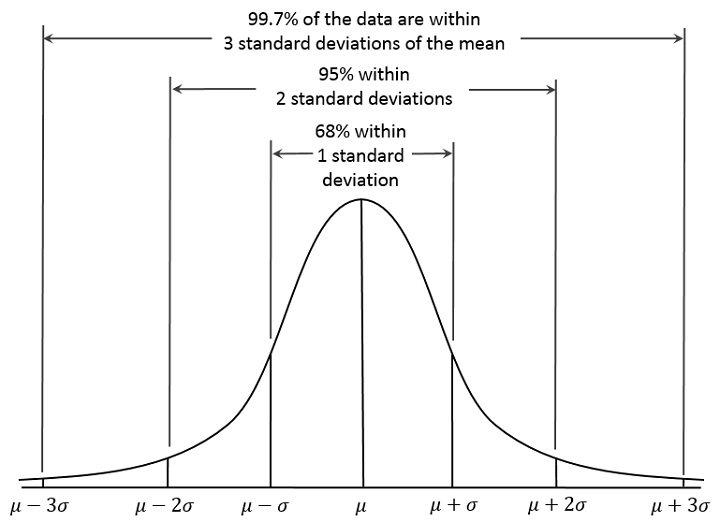
График нормального распределения тесно связан с центральной предельной теоремой (ЦПТ). Согласно ЦПТ, сумма достаточно большого количества слабо зависимых случайных величин имеет распределение, близкое к нормальному.
Нормальное распределение не является абстрактным понятием. Ему соответствуют некоторые характеристики живых организмов в популяции, отклонение от мишени при стрельбе, измерения и их погрешности. Во всех этих случаях наиболее распространена группа близких значений, но есть отклонения как в большую, так и в меньшую сторону.
Примеры решения задач
Рассмотрим несколько простых задач на применение правила 3 сигм.
Задача 1
Имеется выборка жителей богатого дома. Средняя зарплата жильцов составляет 150 000 рублей, среднеквадратичное отклонение равно 20 000 рублей. Определите, жители с какой зарплатой вряд ли могут жить в этом доме: А) 205 000 рублей; Б) 95 000; В) 230 000; Г) 87 000.
Решение
Чтобы решить данную задачу, необходимо определить, каковы верхние и нижние границы возможных зарплат в доме. Для этого воспользуемся правилом 3 сигм.
Значения А, Б входят в диапазон \(\left[90\;000;\;210\;000\right]\) . Значения В, Г не входят в него и, следовательно, являются искомыми грубыми ошибками.
Задача 2
Завод выпускает партии по 100 цилиндрических деталей. Диаметр каждой детали — случайная величина, распределенная по нормальному закону. Математическое ожидание равно 65 мм, а среднее отклонение составляет 0,9 мм. Для упаковки партии используют коробки шириной 6600 мм. Детали кладут в один ряд. Если детали не поместятся в одну коробку, придется брать еще одну. Найдите вероятность, что понадобится только одна коробка.
Решение
Т. к. диаметр каждой детали распределен нормально, то и их общий диаметр также будет распределен нормально.
Чтобы все детали поместились в одну коробку, необходимо, чтобы отклонение диаметра всех деталей отклонялось от ожидаемого не более чем на 100 мм. Это следует из того, что математическое ожидание общего диаметра всех деталей равно \(65\cdot100=6500\) . А ширина коробки составляет 6600 мм.
Для расчета воспользуемся формулами дисперсии и правилом 3 сигм, чтобы вычислить вероятность, что понадобится только одна коробка.
Стандартное отклонение
Стандартное отклонение (англ. Standard Deviation) — простыми словами это мера того, насколько разбросан набор данных.
Вычисляя его, можно узнать, являются ли числа близкими к среднему значению или далеки от него. Если точки данных находятся далеко от среднего значения, то в наборе данных имеется большое отклонение; таким образом, чем больше разброс данных, тем выше стандартное отклонение.
Стандартное отклонение обозначается буквой σ (греческая буква сигма).
Стандартное отклонение также называется:
- среднеквадратическое отклонение,
- среднее квадратическое отклонение,
- среднеквадратичное отклонение,
- квадратичное отклонение,
- стандартный разброс.
Использование и интерпретация величины среднеквадратического отклонения
Стандартное отклонение используется:
- в финансах в качестве меры волатильности,
- в социологии в опросах общественного мнения — оно помогает в расчёте погрешности.
Рассмотрим два малых предприятия, у нас есть данные о запасе какого-то товара на их складах.
| День 1 | День 2 | День 3 | День 4 | |
|---|---|---|---|---|
| Пред.А | 19 | 21 | 19 | 21 |
| Пред.Б | 15 | 26 | 15 | 24 |
В обеих компаниях среднее количество товара составляет 20 единиц:
- А -> (19 + 21 + 19+ 21) / 4 = 20
- Б -> (15 + 26 + 15+ 24) / 4 = 20
Однако, глядя на цифры, можно заметить:
- в компании A количество товара всех четырёх дней очень близко находится к этому среднему значению 20 (колеблется лишь между 19 ед. и 21 ед.),
- в компании Б существует большая разница со средним количеством товара (колеблется между 15 ед. и 26 ед.).
Если рассчитать стандартное отклонение каждой компании, оно покажет, что
- стандартное отклонение компании A = 1,
- стандартное отклонение компании Б ≈ 5.
Стандартное отклонение показывает эту волатильность данных — то, с каким размахом они меняются; т.е. как сильно этот запас товара на складах компаний колеблется (поднимается и опускается).
Расчет среднеквадратичного (стандартного) отклонения
Формулы вычисления стандартного отклонения

Где:
σ — стандартное отклонение,
xi — величина отдельного значения выборки,
μ — среднее арифметическое выборки,
n — размер выборки.
Эта формула применяется, когда анализируются все значения выборки.

Где:
S — стандартное отклонение,
n — размер выборки,
xi — величина отдельного значения выборки,
xср — среднее арифметическое выборки.
Эта формула применяется, когда присутствует очень большой размер выборки, поэтому на анализ обычно берётся только её часть.
Единственная разница с предыдущей формулой: “n — 1” вместо “n”, и обозначение «xср» вместо «μ».
Разница между формулами S и σ («n» и «n–1»)
Состоит в том, что мы анализируем — всю выборку или только её часть:
- только её часть – используется формула S (с «n–1»),
- полностью все данные – используется формула σ (с «n»).
Как рассчитать стандартное отклонение?
Пример 1 (с σ)
Рассмотрим данные о запасе какого-то товара на складах Предприятия Б.
| День 1 | День 2 | День 3 | День 4 | |
| Пред.Б | 15 | 26 | 15 | 24 |
Если значений выборки немного (небольшое n, здесь он равен 4) и анализируются все значения, то применяется эта формула:

Применяем эти шаги:
1. Найти среднее арифметическое выборки:
μ = (15 + 26 + 15+ 24) / 4 = 20
2. От каждого значения выборки отнять среднее арифметическое:
x1 — μ = 15 — 20 = -5
x2 — μ = 26 — 20 = 6
x3 — μ = 15 — 20 = -5
x4 — μ = 24 — 20 = 4
3. Каждую полученную разницу возвести в квадрат:
4. Сделать сумму полученных значений:
Σ (xi — μ)² = 25 + 36+ 25+ 16 = 102
5. Поделить на размер выборки (т.е. на n):
(Σ (xi — μ)²)/n = 102 / 4 = 25,5
6. Найти квадратный корень:
√((Σ (xi — μ)²)/n) = √ 25,5 ≈ 5,0498
Пример 2 (с S)
Задача усложняется, когда существуют сотни, тысячи или даже миллионы данных. В этом случае берётся только часть этих данных и анализируется методом выборки.
У Андрея 20 яблонь, но он посчитал яблоки только на 6 из них.
Популяция — это все 20 яблонь, а выборка — 6 яблонь, это деревья, которые Андрей посчитал.
| Яблоня 1 | Яблоня 2 | Яблоня 3 | Яблоня 4 | Яблоня 5 | Яблоня 6 |
| 9 | 2 | 5 | 4 | 12 | 7 |
Так как мы используем только выборку в качестве оценки всей популяции, то нужно применить эту формулу:

Математически она отличается от предыдущей формулы только тем, что от n нужно будет вычесть 1. Формально нужно будет также вместо μ (среднее арифметическое) написать X ср.
Применяем практически те же шаги:
1. Найти среднее арифметическое выборки:
Xср = (9 + 2 + 5 + 4 + 12 + 7) / 6 = 39 / 6 = 6,5
2. От каждого значения выборки отнять среднее арифметическое:
X1 – Xср = 9 – 6,5 = 2,5
X2 – Xср = 2 – 6,5 = –4,5
X3 – Xср = 5 – 6,5 = –1,5
X4 – Xср = 4 – 6,5 = –2,5
X5 – Xср = 12 – 6,5 = 5,5
X6 – Xср = 7 – 6,5 = 0,5
3. Каждую полученную разницу возвести в квадрат:
(X1 – Xср)² = (2,5)² = 6,25
(X2 – Xср)² = (–4,5)² = 20,25
(X3 – Xср)² = (–1,5)² = 2,25
(X4 – Xср)² = (–2,5)² = 6,25
(X5 – Xср)² = 5,5² = 30,25
(X6 – Xср)² = 0,5² = 0,25
4. Сделать сумму полученных значений:
Σ (Xi – Xср)² = 6,25 + 20,25+ 2,25+ 6,25 + 30,25 + 0,25 = 65,5
5. Поделить на размер выборки, вычитав перед этим 1 (т.е. на n–1):
(Σ (Xi – Xср)²)/(n-1) = 65,5 / (6 – 1) = 13,1
6. Найти квадратный корень:
S = √((Σ (Xi – Xср)²)/(n–1)) = √ 13,1 ≈ 3,6193
Дисперсия и стандартное отклонение
Стандартное отклонение равно квадратному корню из дисперсии (S = √D). То есть, если у вас уже есть стандартное отклонение и нужно рассчитать дисперсию, нужно лишь возвести стандартное отклонение в квадрат (S² = D).
Дисперсия — в статистике это «среднее квадратов отклонений от среднего». Чтобы её вычислить нужно:
- Вычесть среднее значение из каждого числа
- Возвести каждый результат в квадрат (так получатся квадраты разностей)
- Найти среднее значение квадратов разностей.
Ещё расчёт дисперсии можно сделать по этой формуле:

Где:
S² — выборочная дисперсия,
Xi — величина отдельного значения выборки,
Xср (может появляться как X̅) — среднее арифметическое выборки,
n — размер выборки.
Правило трёх сигм
Это правило гласит: вероятность того, что случайная величина отклонится от своего математического ожидания более чем на три стандартных отклонения (на три сигмы), почти равна нулю.

Глядя на рисунок нормального распределения случайной величины, можно понять, что в пределах:
- одного среднеквадратического отклонения заключаются 68,26% значений (Xср ± 1σ или μ ± 1σ),
- двух стандартных отклонений — 95,44% (Xср ± 2σ или μ ± 2σ),
- трёх стандартных отклонений — 99,72% (Xср ± 3σ или μ ± 3σ).
Это означает, что за пределами остаются лишь 0,28% — это вероятность того, что случайная величина примет значение, которое отклоняется от среднего более чем на 3 сигмы.
Стандартное отклонение в excel
Вычисление стандартного отклонения с «n – 1» в знаменателе (случай выборки из генеральной совокупности):
1. Занесите все данные в документ Excel.

2. Выберите поле, в котором вы хотите отобразить результат.
3. Введите в этом поле «=СТАНДОТКЛОНА(«
4. Выделите поля, где находятся данные, потом закройте скобки.

5. Нажмите Ввод (Enter).

В случае если данные представляют всю генеральную совокупность (n в знаменателе), то нужно использовать функцию СТАНДОТКЛОНПА.


Коэффициент вариации
Коэффициент вариации — отношение стандартного отклонения к среднему значению, т.е. Cv = (S/μ) × 100% или V = (σ/X̅) × 100%.
8 базовых понятий статистики для науки о данных

Статистика — это разновидность математического анализа, использующая количественные модели и репрезентации для анализа экспериментальных или реальных данных. Главное преимущество статистики — простота представления информации. Недавно я пересматривала материалы по статистике и выделила 8 основных понятий, которые должен знать каждый специалист по обработке данных:
- дескриптивная аналитика;
- вероятность;
- среднее значение;
- изменчивость;
- взаимозависимость переменных;
- вероятностное распределение;
- проверка гипотезы и статистическая значимость;
- регрессия.
Дескриптивная аналитика
Дескриптивная аналитика описывает события в прошлом и помогает бизнесу оценить эффективность деятельности, предоставляя всем участникам процесса контекст, необходимый для интерпретации информации.
Вероятность
Вероятность — это мера возможности наступления события при случайном эксперименте.
Дополнение: P(A)+P(A’) =1
Пересечение: P(A∩B)=P(A)P(B)
Объединение: P(A∪B)=P(A)+P(B)−P(A∩B)
Условная вероятность: P(A|B) — это мера возможности наступления одного события по отношению к другому/-им событию/-ям. P(A|B)=P(A∩B)/P(B), когда P(B)>0.
Независимые события: два события считаются независимыми, если наступление одного из них не влияет на возможность наступления другого. P(A∩B)=P(A)P(B), где P(A) != 0 и P(B) != 0 , P(A|B)=P(A), P(B|A)=P(B).
Взаимоисключающие события: два события считаются взаимоисключающими, если оба они не могут произойти в одно и то же время. P(A∩B)=0 и P(A∪B)=P(A)+P(B).
Теорема Байеса описывает вероятность наступления события, исходя из ранее известной информации об условиях, которые могут иметь отношение к этому событию.
Среднее значение
Среднее арифметическое: среднее значение набора данных.
Медиана: срединное значение упорядоченного набора данных.
Мода: наиболее часто встречающееся значение в наборе данных. Если таких значений несколько, это называется мультимодальным распределением.
Асимметрия: мера симметричности.
Эксцесс: мера, показывающая медленное или быстрое убывание “хвоста” данных относительно нормального распределения.
Изменчивость
Амплитуда: разница между минимальным и максимальным значениями в наборе данных.
Межквартильный размах (IQR): IQR = Q3−Q1
Дисперсия: среднеквадратичное отклонение значений от среднего арифметического, показывающее разброс данных относительно него.
Стандартное отклонение: стандартный разброс между каждым отдельным значением и средним арифметическим, квадратный корень из дисперсии.
Среднеквадратическая ошибка (SE): приблизительная величина стандартного отклонения выборочного распределения.
Взаимозависимость переменных
Причинность: такая зависимость между двумя событиями, когда одно из них влияет на другое.
Ковариантность: количественная мера совокупной изменчивости двух или более переменных.
Корреляция: мера взаимозависимости между двумя переменными с коэффициентом от -1 до 1, нормализованная версия ковариантности.
Ковариантность и корреляция
Вероятностное распределение
Функции вероятностного распределения
Функция распределения масс (PMF): функция, которая указывает, что дискретная случайная переменная в точности равна какому-либо значению.
Функция плотности вероятности (PDF): функция для непрерывных данных, согласно которой значение в любой выборке может расцениваться как добавляющее относительной вероятности тому, что значение случайной переменной равно значению этой выборки.
Функция кумулятивной плотности (CDF): функция, которая указывает, что случайная переменная меньше определённого значения или равна ему.
Непрерывное распределение вероятностей
Равномерное распределение: распределение, при котором все исходы имеют одинаковую вероятность (также известно как прямоугольное распределение).
Нормальное/гауссово распределение: кривая распределения имеет форму колокола и симметрична. Согласно центральной предельной теореме, выборочное распределение средних арифметических приближается к нормальному при увеличении объёма выборки.
Экспоненциальное распределение: вероятностное распределение времени между событиями в пуассоновском точечном процессе.
Распределение хи-квадрат: распределение суммы квадратов стандартных нормальных отклонений.
Дискретное распределение вероятностей
Распределение Бернулли: распределение случайной переменной, при котором для наступления события есть одна попытка и 2 возможных исхода: 1 — успех с вероятностью p и 0 — неудача с вероятностью 1-p.
Биномиальное распределение: распределение некоторого количества успешных исходов события в количестве n независимых экспериментов. У каждого события есть только 2 возможных исхода: 1 — успех с вероятностью p и 0 — неудача с вероятностью 1-p.
Распределение Пуассона: распределение, которое отражает вероятность заданного числа событий k, происходящих в течение фиксированного промежутка времени, если эти события наступают с известной постоянной усреднённой вероятностью λ и независимо от времени.
Проверка гипотезы и статистическая значимость
Нулевая и альтернативная гипотезы
Нулевая гипотеза: общее утверждение, согласно которому между измеряемыми явлениями или их группами нет взаимозависимости.
Альтернативная гипотеза: гипотеза, обратная нулевой.
При проверке статистической гипотезы ошибка типа I — это непринятие истинной нулевой гипотезы, а ошибка типа II — принятие ложной нулевой гипотезы.
Интерпретация
P-значение: вероятность того, что данная статистика будет иметь как минимум такие же экстремальные значения, как и ранее наблюдаемая, при условии, что нулевая гипотеза верна. Когда p-значение > α, нулевую гипотезу невозможно не принять, в том время как если p-значение ≤ α, нулевая гипотеза не принимается, следовательно, мы имеем статистически значимый результат.
Критическое значение: точка на шкале статистики, выше которой нулевая гипотеза не принимается (зависит от уровня значимости проверки, α). Значение зависит от статистики (отдельная для каждого типа проверки) и уровня значимости проверки α (определяет точность проверки).
Уровень значимости и область непринятия: область непринятия зависит от уровня значимости. Уровень значимости (α) — это вероятность непринятия нулевой гипотезы при условии, что она верна.
Z-тест — это статистическая проверка, при которой распределение статистики при нулевой гипотезе может приближаться к нормальному, а также проверяет среднее арифметическое распределения при известной генеральной дисперсии. Следовательно, при больших объёмах выборки или известной генеральной дисперсии многие статистические проверки удобно проводить в форме Z-тестов.
T-тест — это статистическая проверка, используемая, когда генеральная дисперсия неизвестна, а объём выборки небольшой (n < 30).
Парная выборка означает, что сбор данных производится дважды с одной и той же группы, человека, образца, предмета. Независимая выборка подразумевает, что две выборки должны быть получены с двух абсолютно разных совокупностей.
ANOVA (дисперсионный анализ)
Аназиз ANOVA позволяет выяснить, являются ли результаты эксперимента статистически значимыми. При однофакторном дисперсионном анализе сравниваются два средних арифметических двух независимых групп с помощью одной независимой переменной. Двухфакторный дисперсионный анализ — продолжение однофакторного, здесь для вычисления главного эффекта и эффекта взаимодействия используются две независимые переменные.
Тест хи-квадрат
Тест хи-квадрат определяет, соответствует ли модель нормальному распределению при введении набора дискретных данных. Критерий согласия определяет, соответствует ли распределению выборка совокупности одной категориальной переменной. Критерий независимости хи-квадрат позволяет проверить два набора данных на предмет наличия взаимосвязи.
Регрессия
Линейная регрессия
Постулаты линейной регрессии:
- линейная зависимость;
- многомерная нормальность;
- небольшая мультиколлинеарность или её отсутствие;
- небольшая автокорреляция или её отсутствие;
- гомоскедастичность.
Линейная регрессия — это линейный подход к моделированию взаимозависимости между зависимой и независимой переменными. Независимая переменная — это контролируемая в ходе научного эксперимента переменная, используемая для измерения влияния на зависимую переменную. Зависимая переменная — это переменная, измеряемая в ходе научного эксперимента.
Множественная линейная регрессия — это линейный подход к моделированию взаимозависимости между одной зависимой и двумя или более независимыми переменными.
Этапы построения линейной регрессии
Этап 1: Проанализируйте описание модели, причинные зависимости и направленность.
Этап 2: Проверьте данные, в том числе категориальные, недостающие и выбросы.
- Выброс — это образец данных, значительно отличающийся от других наблюдений. Можно использовать метод стандартного отклонения и межквартильного размаха (IQR).
- Вспомогательная переменная принимает только 0 и 1 в качестве значения и отражает влияние на категориальные переменные.
Этап 3: Простой анализ — проверьте результат сравнения независимой и зависимой переменных, а также двух независимых переменных.
- Используйте диаграмму рассеивания для проверки взаимозависимости.
- Когда более двух независимых переменных имеют сильную взаимосвязь, это называется мультиколлинеарностью. Для количественной оценки можно использовать фактор, увеличивающий дисперсию (VIF): если VIF > 5, между переменными существует сильная взаимосвязь, если VIF > 10, между переменными возникает мультиколлинеарность.
- Величина взаимодействия отражает изменения в наклоне кривой между значениями.
Этап 4: Множественная линейная регрессия — проверьте модель и истинные переменные.
Этап 5: Остаточный анализ.
- Проверьте нормальное распределение, а также соответствуют ли ему остатки.
- Гомоскедастичность описывает ситуацию, когда величина погрешности одинакова для всех значений независимых переменных, следовательно, значения остатков также одинаковы на протяжении всей кривой регрессии.
Этап 6: Интерпретация результатов регрессии.
Статистика — Стандартное (среднеквадратичное) отклонение
Стандартное отклонение — это наиболее часто используемая мера вариации, которая описывает разброс данных.
Стандартное отклонение
Стандартное отклонение (σ) измеряет, насколько "типичное" наблюдение отличается от среднего значения данных (μ).
Стандартное отклонение является важным для многих статистических методов.
Вот гистограмма возраста всех 934 лауреатов Нобелевской премии до 2020 года, показывающая стандартные отклонения.:
Каждая пунктирная линия на гистограмме показывает сдвиг на одно дополнительное стандартное отклонение.
Если данные нормально распределены
- Примерно 68.3% данных находится в пределах 1 стандартного отклонения от среднего (от μ-1σ до μ+1σ)
- Примерно 95.5% данных находится в пределах 2 стандартных отклонений от среднего (от μ-2σ до μ+2σ)
- Примерно 99.7% данных находится в пределах 3 стандартных отклонений от среднего (от μ-3σ до μ+3σ)
Примечание: Нормальное распределение имеет форму колокола и равномерно распространяется с обеих сторон.
Расчет стандартного отклонения
Формулы почти одинаковы, и для обозначения стандартного отклонения (\(\sigma\)) и для выборки используются разные символы (\(s\)).
Расчет стандартного отклонения (\(\sigma\)) выполняется по этой формуле:
Расчет выборки стандартного отклонения (\(s\)) выполняется по этой формуле:
\(n\) это общее количество наблюдений.
\(\sum \) это символ для сложения списка чисел.
\(x_\) это список значений в данных: \(x_<1>, x_<2>, x_<3>, \ldots \)
\(\mu\) — среднее значение совокупности, а \(\bar
\( (x_ — \mu ) \) и \( (x_ — \bar
Каждая разница возводится в квадрат и складывается.
Затем сумма делится на \(n\) or (\( n — 1 \)) и затем мы находим квадратный корень.
Используя эти 4 примера значений для расчета стандартного отклонения генеральной совокупности:
Сначала мы должны найти среднее значение:
Затем мы находим разницу между каждым значением и средним значением \( (x_— \mu)\):
- \( 4-9 \; \:= -5 \)
- \( 11-9 = 2 \)
- \( 7-9 \; \:= -2 \)
- \( 14-9 = 5 \)
Затем каждое значение возводится в квадрат или умножается само на себя \( ( x_— \mu )^2\):
- \( (-5)^2 = (-5)(-5) = 25 \)
- \( 2^2 \; \; \; \; \; \, = 2*2 \; \; \; \; \; \; \; \: = 4 \)
- \( (-2)^2 = (-2)(-2) = 4 \)
- \( 5^2 \; \; \; \; \; \, = 5*5 \; \; \; \; \; \; \; \: = 25 \)
Затем все квадраты разностей складываются \( \sum (x_ -\mu )^2\):
\( 25 + 4 + 4 + 25 = 58\)
Затем сумма делится на общее количество наблюдений, \( n \):
\( \displaystyle \frac<58> <4>= 14.5\)
Наконец, извлекаем квадратный корень из этого числа:
Таким образом, стандартное отклонение значений примера примерно: \(3.81 \)
Расчет стандартного отклонения с помощью программирования
Стандартное отклонение можно легко вычислить с помощью многих языков программирования.
Использование программного обеспечения и программирования для расчета статистики более распространено для больших наборов данных, поскольку расчет вручную становится затруднительным.
Стандартное отклонение совокупности
Пример
В Python используйте метод std() библиотеки NumPy, чтобы найти стандартное отклонение значений 4,11,7,14:
Пример
Используйте формулу R, чтобы найти стандартное отклонение значений 4,11,7,14:
Стандартное отклонение выборки
Пример
В Python используйте метод std() библиотеки NumPy, чтобы найти выборку стандартного отклонения значений 4,11,7,14:
x = numpy.std(values, ddof=1)
Пример
Используйте функцию R sd() чтобы найти выборку стандартного отклонения значений 4,11,7,14: