What Does Xi Stand For In Statistics? Best 23 Answer
Are you looking for an answer to the topic “what does xi stand for in statistics“? We answer all your questions at the website barkmanoil.com in category: Newly updated financial and investment news for you. You will find the answer right below.
xi represents the ith value of variable X. For the data, x1 = 21, x2 = 42, and so on. • The symbol Σ (“capital sigma”) denotes the summation function. This is called the joint probability. p(x = xi; y = yi). If we x x to, say xi then the probability of y taking on a particular. value, say yj, is given by the conditional probability.
- Find the upper limit of the class.
- Find the lower limit of the class.
- Add the two limits.
- Then divide the sum by two.
- You will get the class mark.
| Marks obtained (xi) | Number of students (fi) | fixi |
|---|---|---|
| 88 | 2 | 176 |
| 92 | 3 | 276 |
| 95 | 1 | 95 |
| Total | Σ fi = 30 | Σ fixi = 1779 |
| Symbol | Symbol Name | Example |
|---|---|---|
| μ | population mean | μ = 10 |
| var(X) | variance | var(X) = 4 |
| E(X | Y) | conditional expectation | E(X | Y=2) = 5 |
| std(X) | standard deviation | std(X) = 2 |
What Does Xi Stand For In Statistics
Table of Contents
How do you calculate XI in statistics?
- Find the upper limit of the class.
- Find the lower limit of the class.
- Add the two limits.
- Then divide the sum by two.
- You will get the class mark.
What does Xi and Yi mean in statistics?
This is called the joint probability. p(x = xi; y = yi). If we x x to, say xi then the probability of y taking on a particular. value, say yj, is given by the conditional probability.
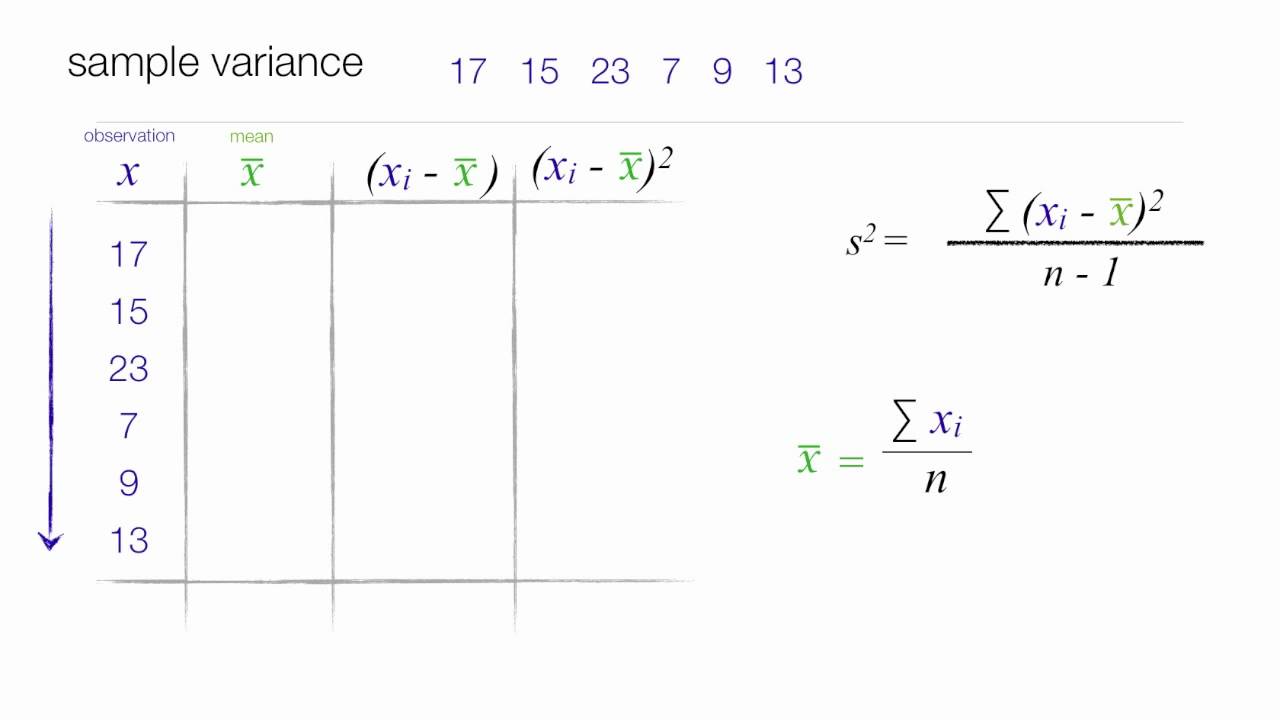
How to calculate Standard Deviation and Variance
Images related to the topicHow to calculate Standard Deviation and Variance
How To Calculate Standard Deviation And Variance
How do you find XI and FI in statistics?
| Marks obtained (xi) | Number of students (fi) | fixi |
|---|---|---|
| 88 | 2 | 176 |
| 92 | 3 | 276 |
| 95 | 1 | 95 |
| Total | Σ fi = 30 | Σ fixi = 1779 |
What are the symbols for statistics?
| Symbol | Symbol Name | Example |
|---|---|---|
| μ | population mean | μ = 10 |
| var(X) | variance | var(X) = 4 |
| E(X | Y) | conditional expectation | E(X | Y=2) = 5 |
| std(X) | standard deviation | std(X) = 2 |
How do you find the XI of grouped data?
Step 1(RED) Find xi as Class mark = (Upper class limit + Lower class limit)/ 2 , for each i. Step 2: (GREEN) Find fixi for each i. Step2: Find xi as Class mark = (Upper class limit + Lower class limit)/ 2 , for each i.
What is FIUI in statistics?
fi= frequency of each class.
What is XI in correlation coefficient?
(Zxi= is the standard score for Xi. It tells you how many standard deviation units (SDx) the score Xi is from its mean. ) Pearson’s r is always between -1 and +1, where -1 means a perfect negative, +1 a perfect positive relationship and 0 means the perfect absence of a relationship.
See some more details on the topic what does xi stand for in statistics here:
What does Xi and Yi mean in statistics? – qa-all.com
xi represents the ith value of variable X . For the data, x1 = 21, x2 = 42, and so on. What does Yi mean in stats? Yi independent with …
How to find xi in statistics? – Maths Q&A – Byju’s
xi is designated as the classmark. To find xi execute these steps : Find the upper limit of the class; Find the lower limit of the class; Add the two limits …
What Is Xi Mean In Statistics? – Whoat Where Why
In Statistics the frequency of an event xi is the number fi of times the event occurred in the experiment or …
What is fi XI? – qa-faq.com
How do you calculate fi XI in statistics? What does fixi mean in statistics? What is the XI in standard …
What is the value of σ?
A sigma value is a description of how far a sample or point of data is away from its mean, expressed in standard deviations usually with the Greek letter σ or lower case s. A data point with a higher sigma value will have a higher standard deviation, meaning it is further away from the mean.
Statistical Notation
Images related to the topicStatistical Notation
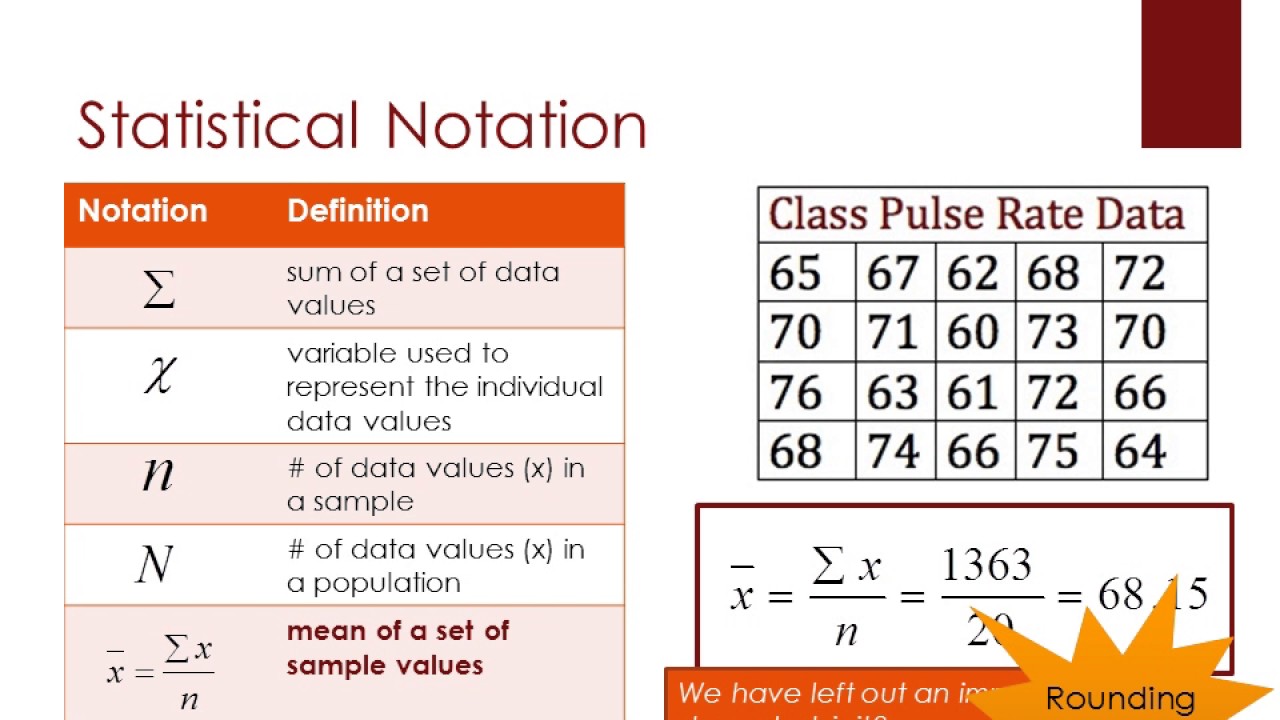
Statistical Notation
What is XI in statistics class 11?
xi represents the ith value of variable X. For the data, x1 = 21, x2 = 42, and so on. … For the data, Σxi = 21 + 42 + 52 = 290.
What is upper limit and lower limit?
Upper limit is the highest value of the class interval. Similarly, the lower limit is the smallest value of the class interval. For finding the actual upper limits and actual lower limits , we need to make the upper limit of a certain class and lower limit of the next class to be equal and same for the lower limit.
How do you find D1 in statistics?
- = Value of [(30 + 1) / 10]th data.
- = Value of 3.1st data, which is 0.1 of the way between scores 55 and 57.
- = 55 + 2 (0.1) = 55.2 = D1.
- D1 means that 10% of the data set falls below 55.2.
Where is FIUI in step deviation method?
Find ui i =(xi i −A)/h, where h is the class size. Use the formula: A + h [∑ui i fi i / ∑fi i ]
What is UI in mean?
The user interface (UI) is the point of human-computer interaction and communication in a device. This can include display screens, keyboards, a mouse and the appearance of a desktop. It is also the way through which a user interacts with an application or a website.
How do you interpret a correlation coefficient?
A positive correlation coefficient indicates that an increase in the first variable would correspond to an increase in the second variable, thus implying a direct relationship between the variables. A negative correlation indicates an inverse relationship whereas one variable increases, the second variable decreases.
Order Statistics of Uniform Distribution: expectation of the largest and smallest order statistics
Images related to the topicOrder Statistics of Uniform Distribution: expectation of the largest and smallest order statistics

Order Statistics Of Uniform Distribution: Expectation Of The Largest And Smallest Order Statistics
What does the correlation coefficient tell you?
The correlation coefficient is the specific measure that quantifies the strength of the linear relationship between two variables in a correlation analysis. The coefficient is what we symbolize with the r in a correlation report.
What is R value in statistics?
Put simply, it is Pearson’s correlation coefficient (r). Or in other words: R is a correlation coefficient that measures the strength of the relationship between two variables, as well as the direction on a scatterplot. The value of r is always between a negative one and a positive one (-1 and a +1).
Related searches to what does xi stand for in statistics
- what does i 1 mean in statistics
- what does xi and yi mean in statistics
- sample mean formula
- xi in statistics stands for
- mean x
- mean formula in statistics
- sample mean
- sample variance
- what is xi and fi in statistics
- Mean formula in statistics
- xi in statistics means
- how to calculate xi in statistics
- what does * mean in statistics
- Sample mean
- what does meu mean in statistics
Information related to the topic what does xi stand for in statistics
Here are the search results of the thread what does xi stand for in statistics from Bing. You can read more if you want.
You have just come across an article on the topic what does xi stand for in statistics. If you found this article useful, please share it. Thank you very much.
14. Индексы в статистике: методы исчисления, примеры

«Индекс» в переводе с латинского – указатель, показатель.
В статистике под индексом понимается относительная величина, характеризующая соотношение значений определенного показателя во времени, пространстве, а также сравнение фактических данных с планом или другим нормативом.
С помощью индексов можно определить количественные изменения самых различных показателей функционирования народного хозяйства, развития социально-экономических процессов и т.п.
В экономической работе с помощью индексов можно объективно и точно показать изменения в росте или снижении производства, изменения в урожайности, состоянии себестоимости и цен выпускаемой продукции, численности работающих, производительности труда, заработной платы, изменения в цене акций на фондовых рынках (индекс Доу Джонса), сравнительную характеристику изменения погоды за определенный период времени (температуры, влажности, давления) и т.д. и т.п.
Индексы в своей основе представляют разновидность относительных величин, характеризующих средние показатели исследуемых процессов или явлений в социально-экономических и других областях деятельности общества. Однако от средних величин, рассмотрению которых посвящены были предыдущие темы, индексы отличаются тем, что они воплощают в себе, как правило, сводные, обобщающие показатели, т.е. выражают собой некоторое содержание, свойственное всем рассматриваемым явлениям и процессам.
Индексный метод имеет свою терминологию и символы.
Обозначения индексируемых величин:
i – индивидуальный индекс, его вычисляют для одной единицы совокупности;
I – общий (сводный) индекс (он определяется для всех единиц совокупности);
q – количество (объем) какого-либо товара в натуральном выражении;
p – цена единицы товара;
z – себестоимость единицы продукции;
t – затраты времени на производство единицы продукции, трудоемкость;
T – общие затраты времени на производство (tq) или численность рабочих;
pq – стоимость продукции или товарооборот;
zq – издержки производства.
Знак внизу справа означает период, например:
Экономический индекс – это относительная величина, которая характеризует изменение исследуемого явления во времени, в пространстве или по сравнению с некоторым эталоном (планируемым, нормативным уровнем и т.п.).
Если в качестве базы сравнения используется уровень за какой-либо предшествующий период – получают динамический индекс; если же базой является уровень того же явления по другой территории – территориальный индекс.
Индексируемая величина – показатель, изменение которого характеризуется индексом, она содержится в названии самого индекса, например: индекс цен, индекс заработной платы, индекс физического объема продукции и т.д.
Вес индекса – величина, служащая для целей соизмерения индексируемых величин.
Классификация индексов:
- по степени охвата явления индексы бываютиндивидуальные и сводные;
- по виду весов – с постоянными и переменными весами;
- в зависимости от формы построения – агрегатные и сводные;
- по базе сравнения – динамические и территориальные;
- по характеру объема исследования – общие индексы подразделяются наколичественные и качественные;
- по составу явления – постоянного (фиксированного) состава и переменного состава,
- по периоду исчисления – годовые, квартальные, месячные, недельные и т.д.
В экономическом анализе индексы используются не только для сопоставления уровней изучаемого явления, но главным образом для определения экономической значимости причин, объясняющих абсолютное различие сравниваемых уровней.
Экономические индексы позволяют: 1) измерить динамику социально-экономического явления за два и более периодов времени; 2) измерить динамику среднего экономического показателя; 3) измерить соотношение показателей по разным регионам; 4) определить степень влияния изменений значений одних показателей на динамику других; 5) пересчитать значения макроэкономических показателей из фактических цен в сопоставимые.
Методика построения агрегатного индекса предусматривает решение трех вопросов: 1) какая величина будет индексируемой; 2) по какому составу разнородных элементов явления необходимо исчислить индекс; 3) что будет служить весом при расчете индекса.
Правило при выборе индекса
При выборе веса индекса принято руководствоваться следующим правилом: если строится индекс количественного показателя, то веса берутся за базисный период, при построении индекса качественного показателя используются веса отчетного периода.
Расчет индивидуальных индексов
Простейшим показателем, используемым в индексном анализе, является индивидуальный индекс, который характеризует изменение во времени экономических величин, относящихся к одному объекту, например:
– индекс цены определенного продукта (товара), где  и
 цена товара, соответственно в текущем и в базисном периоде

‑ индекс объема одного определенного продукта (товара)

‑ индекс себестоимости единицы отдельного продукта

‑ индекс численности работников и т.д.

Все индивидуальные индексы показывают, каково соотношение между отчетным (со знаком «1») и базисным (со знаком «0») показателями или во сколько раз увеличилась (уменьшилась) индексируемая величина.
Все индивидуальные индексы по сути являются относительными величинами динамики или коэффициентами (темпами) роста (снижения).
Индивидуальные индексы характеризуют изменение отдельных единиц статистической совокупности. Характерной чертой индексов является то, что все они образуют системы взаимосвязанных показателей.
Расчеты индивидуальных индексов просты по своей сущности и выполняются путем вычисления отношения двух индексируемых величин. Индивидуальные индексы могут исчисляться в виде индексного ряда за несколько периодов.
Существуют два способа расчета индивидуальных индексов: цепной и базисный.
При цепном способе расчета за базу отношения принимается индексируемая величина соседнего прошлого периода, в этом случае база расчета в ряду постоянно меняется.
При базисном способе расчета за базу принимается индексируемая величина какого-либо отдельного периода.
Расчет общих индексов
В области экономических явлений наряду с индивидуальными индексами, характеризующими изменения единичных элементов, возникает необходимость расчета сводных относительных величин, обобщающих изменения определенного показателя в сложной совокупности, отдельные элементы которой несопоставимы (в физических единицах) и не могут суммироваться.
Например, нельзя тонны нефти и тонны стали, а также цены на разные товары (мясо, молоко, обувь, одежду и т.п.).
Для обобщения относительного изменения определенного показателя в сложной совокупности рассчитываются общие (сводные ) индексы.
Общий (сводный) индекс – показатель, измеряющий динамику сложного явления, составные части которого непосредственно несоизмеримы в физических единицах.
Например, по данным органов статистики, цены на продовольственные товары в декабре 2018 г. составили 116,1% по отношению к предыдущему месяцу (ноябрю) и 175 % по отношению к декабрю 2017 г.
С помощью общих индексов характеризуется изменение цен на товары, изменение уровня жизни, развитие производства отдельных отраслей и экономики в целом и многое другое.
Индексы могут иметь разный характер.
Одни являются объемными (количественными); другие условно можно назвать качественными: они представляют собой показатели, определяемые на какую-то единицу (цена единицы товара, себестоимость единицы продукции, урожайность с 1 га и т.д.).
В соответствии с этим и индексы можно подразделить на индексы количественных показателей (индекс физического объема производства, индекс продаж акций и т.п.) и качественных (индекс цен, индекс себестоимости, индекс заработной платы и пр.)
Каждый из этих индексов имеет свои особенности, но любой общий индекс может быть исчислен двумя способами: как агрегатный и как средний из индивидуальных.
Рассмотрим оба способа построения (исчисления) общих индексов.
Общий индекс, полученный путем сопоставления итоговых показателей, количественно выражающих сложное явление в отчетном и базисном периодах с помощью соизмерителей, называют агрегатным.
Соизмерители необходимы для перехода от натуральных измерителей, разнородных единиц статистической совокупности к однородным показателям.
При этом в числителе и знаменателе общего индекса изменяется только значение индексируемой величины, а их соизмерители являются постоянными величинами и фиксируются на одном уровне ‑ это необходимо для того, чтобы на величине индекса сказывалось лишь влияние фактора, который определяет изменения индексируемой величины.
Пример. В качестве соизмерителей индексируемых величин выступают тесно связанные с ними экономические показатели: цена, количество, себестоимость единицы продукции или затраты на единицу продукции и др.
При сравнении числителя и знаменателя данной формулы в разности определяется показатель абсолютного прироста.
При сравнении разности числителя и знаменателя индексного отношения получаем показатель, характеризующий прирост суммы в текущем периоде по сравнению с базисным периодом.
Обозначая объем продукции (товаров через q, а цены – через p, можно представить стоимость продукции в базисном периоде как  , а в отчетном как
 . Сопоставляя эти два показателя, получим индекс стоимости (товарооборота).

Который показывает относительное изменение стоимости продукции как за счет изменения цен, так и за счет изменения объема отдельных товаров.

Если же продукцию двух сравниваемых периодов оценить в одних и тех же неизменных ценах, то очевидно, что стоимость продукции двух периодов будет отличаться лишь за счет изменения объема продукции. Поэтому общий индекс, исчисленный как отношение стоимости продукции двух периодов в одних и тех же ценах, называют агрегатный индекс физического объема .
В агрегатном индексе физического объема в качестве соизмерителя различных товаров принимаются цены базисного периода  или цены, неизменные в течении ряда лет
 (такие цены называют также сопоставимыми).

где  и
 ‑ объем продукции различных видов соответственно в базисном и отчетном периодах.
Отметим, что суммы в числителе и знаменателе имеют вполне реальный смысл:
 ‑ стоимость продукции базисного периода;
 ‑ стоимость продукции отчетного периода в базисных ценах.
Разность между числителем и знаменателем агрегатного индекса характеризует изменение в абсолютном выражении результативного показателя за счет изменения индексируемой величины.
Пример. Предположим, предприятие выпускает три вида неоднородной продукции. Данные о производстве и цены за два периода приведем в (табл. 14.1).
Таблица 14.1. – Данные о производстве продукции за 2 периода

Следовательно, общий объем (выпуск) продукции в отчетном периоде по сравнению с базисным составил 70,2% (или снизился на 29,8%).
А в абсолютном выражении за счет уменьшения выпуска стоимость продукции в отчетном периоде снизилась на 650 тыс. руб., вычитаем из числителя знаменатель

Как уже отмечалось, при построении агрегатного индекса физического объема могут использоваться и другие соизмерители. Так, например, если принять в качестве соизмерителей себестоимость единицы продукции в базисном периоде z0, то агрегатный индекс физического объема можно записать как:

Разность между числителем и знаменателем покажет, как изменились общие затраты (издержки) на производство в связи с изменением выпуска продукции:ли в качестве соизмерителей принять затраты времени на единицу продукции в базисном периоде, то формула агрегатного индекса физического объема будет иметь вид:

разность будет характеризовать изменение общих затрат времени на производство продукции за счет изменения объема выпуска.
Агрегатный индекс цен. По аналогии с индексом физического объема для определенного набора товаров (продуктов) может быть построен и агрегатный индекс цен (индекс качественного показателя). При этом рассуждения остаются теми же: если нельзя суммировать цены на различные товары, то можно суммировать и сопоставлять стоимости этих товаров.
Однако, сопоставляя два значения стоимости рq, мы должны показать изменение последней лишь за счет изменения цен р, т.е. необходимо устранить влияние изменения количества производимой (или реализуемой) в разные периоды продукции q на стоимостный показатель продукции. Для этого один и тот же количественный набор продуктов надо оценить в ценах отчетного и базисного периодов и затем сопоставить первую величину со второй. Таким образом, в агрегатном индексе цен индексируемой величиной является, естественно, цена р, а соизмерителем (весами) ‑ количество произведенных (реализованных) товаров q, принятое на уровне базисного или отчётного периода.
Агрегатная формула общего индекса цен была впервые предложена в 1864 г. немецким ученым Э. Ласпейресом. Он предлагал строить агрегатный индекс цен, приняв в качестве весов продукцию базисного периода q0:

В 1874 г. другой немецкий учёный, Г. Пааше, предложил строить агрегатный индекс цен по продукции текущего периода q1:

Каждый из этих индексов имеет свои особенности, которым отдается предпочтение в конкретных условиях, использования.
Так, например, индекс Цен Ласпейреса удобен для оперативной (недельной, месячной, квартальной) информации об изменении цен на определенный фиксированный набор товаров, когда пересчет каждый раз на текущий набор (количество) товаров сопряжен с большими затратами, труда и времени.
По формуле Ласпейреса рассчитывают индекс потребительских цен (ИПЦ).
В то же время формуле Пааше отдается предпочтение, когда индекс цен рассматривается в системе с индексом стоимости и индексом физического объема. В этом случае, чтобы обеспечивать взаимосвязь между индексом стоимости и индексом физического объема.
Кроме того, при расчете индекса цен; по формуле Пааше, вычитая из числителя знаменатель, легко определить в абсолютном выражении сумму потерь (или прибыли) за счет изменения цен на продукцию отчетного (текущего) периода.
Рассмотрим расчет агрегатных индексов цен на примере.
Таблица 14.2. – Данные о реализации продукции за 2 периода (цифры условные)
Чтобы определить, как в среднем изменились цены на все продукты (или какова средняя величина изменения цен), рассчитаем сводный (общий) индекс цен в форме агрегатного индекса:


Вывод: т.е. по формуле Ласпейреса цены по всем продуктам выросли в среднем на 16,3%, а по формуле Пааше ‑ на 15,9% .
Расхождение не очень большое (на 0,4), но все же есть. Какому же индексу отдать предпочтение? На таком уровне исследования (по отдельному хозяйству и совокупности хозяйств) предпочтение следует отдать индексу Пааше, поскольку он показывает реальное изменение стоимости продукции, реализованной в отчетном периоде, за счет изменения цен. В этом индексе числитель ‑ реальная величина, фактическая выручка, полученная от реализации продукции в отчетном периоде, а знаменатель ‑ условная величина, показывающая, какой была бы выручка, если бы продукция отчетною периода продавалась по базисным ценам.
Разность между ними, (56200 ‑ 48500 = 7700 руб.), показывает в данном случае, какую прибыль дополнительно получило хозяйство при реализации продукции в отчетном периоде за счет роста цен.
В формуле же индекса цен Ласпейреса в знаменателе содержится реальная выручка (стоимость) от реализации в базисном периоде, а в числителе ‑ условная величина, характеризующая, какой была бы выручка от реализации продукции базисного периода по ценам отчетного периода. Разность практически не представляет интереса, так как эта величина слишком отвлеченная: она показывает, насколько изменилась бы выручка (стоимость) в прошлом (базисном) периоде, если бы базисная продукция была реализована по текущим (отчетным) ценам.
Кроме того, при расчете индекса цен по формуле Пааше, легко увязываются изменения трех взаимосвязанных показателей: стоимости (выручки), объема реализации и цен. Так, по данным табл. 14.2 индекс стоимости продукции

(или 122,2%), т.е. стоимость продукции (выручка от продажи) в отчетном периоде увеличилась на 22,2%, что составило в абсолютном выражении 10200 руб. (56200 – 46000).
Индекс физического объема реализаций по данным табл. 14.2

В абсолютном выражении увеличение стоимости за счет изменения объема реализации составило 2500 руб. (48500 – 46000)
Таким образом, имеет место увязка индексов (относительного изменения показателей):

А также абсолютных изменений: в нашем примере 10200 = 7700 + 2500,т.е. общее изменение стоимости продукции равно сумме приростов за счет изменения цен и за счет изменения объема.
В начале XX в. американский экономист И. Фишер предложил вместо формул индексов цен Ласпейреса и Пааше использовать среднюю геометрическую из них, т.е. корень квадратный из произведения индексов иен Ласпейреса и Пааше:

(Этот индекс назван им идеальным, поскольку в нем не отдается предпочтение ни продукция базисного периода, ни продукции текущего периода.
Кроме того, этот индекс «обратим» во времени, т.е. если рассчитывать индекс базисного периода к отчетному, он будет равен обратной величине первоначального индекса (т.е. отчетного периода к базисному). Другими словами, перемножение таких, «обратных» индексов дает единицу.
Однако индекс Фишера из-за его формальности и трудности экономической интерпретации используется редко, в основном при территориальных сопоставлениях.
Мы рассмотрели расчет агрегатных индексов физического объема и цен как наиболее типичных представителей агрегатных индексов соответственно для количественных и качественных индексируемых показателей.
По аналогии можно записать агрегатные индексы для многих других показателей.
Как найти XI в статистике?
Аналогично, что означают Xi и Yi в статистике? Это называется совместная вероятность. p(x=xi; y=yi). Если мы от xx до, скажем, xi, то вероятность того, что y примет конкретное значение. значение, скажем, yj, определяется условной вероятностью.
Какова ценность Си? XI = X + I = 10 + 1 = 11. Следовательно, значение римских цифр XI равно 11.
Похожие страницы:Блог
Демистификация процента 20/60: как его эффективно рассчитать?
Сколько секунд в месяце? В некоторых месяцах разное количество секунд?
Какие есть 3 вида налогов?
Как найти среднюю точку между двумя точками?
Что такое XI в стандартном отклонении? n — количество точек данных в вашем наборе данных, xi является точкой в этом наборе данных, а ¯x — среднее значение данных. Теперь, говоря простым языком, это уравнение говорит вам взять каждую точку в наборе данных («ось») и вычесть из них среднее значение.
Во-вторых Как вы находите fi и Xi? Ответ
- Пошаговое объяснение:
- найти xi ..-
- ◆верхний предел+нижний предел/2=метка класса и fi=частота.
- Умножьте оба, и вы получите фикс.
Что такое XI в таблице распределения частот?
В статистике частота события xi равна количество fi раз, когда событие произошло в эксперименте или исследовании.
тогда что означает σ в статистике? Единицей измерения, обычно используемой, когда речь идет о статистической значимости, является стандартное отклонение, выражается строчной греческой буквой сигма (σ). … Термин относится к степени изменчивости в данном наборе данных: все точки данных сгруппированы вместе или сильно разнесены.
Как найти XI сгруппированных данных? Решение: По прямому методу. Шаг 1 (КРАСНЫЙ) Найдите xi как Оценка класса = (Верхний предел класса + Нижний предел класса) / 2 , для каждого я. Шаг 2: (ЗЕЛЕНЫЙ) Найдите fixi для каждого я. Шаг 2: Найдите xi как метку класса = (верхний предел класса + нижний предел класса)/ 2 для каждого i.
Что я имею в виду в статистике?
В статистике L-статистика — это статистика (функция набора данных), которая линейная комбинация статистики заказов; «L» означает «линейный».
Что такое 1 стандартное отклонение от среднего? Используя стандартное отклонение, статистики могут определить, имеют ли данные нормальную кривую или другое математическое соотношение. Если данные ведут себя по нормальной кривой, то 68% точек данных будут находятся в пределах одного стандартного отклонения от средней или средней точки данных.
Что означает эпсилон в статистике?
е: “Срок ошибки” в регрессии/статистике; чаще используется для обозначения произвольно малого положительного числа. ∈ (вариант эпсилон) Эта версия эпсилон используется в теории множеств для обозначения «принадлежит» или «находится в множестве»: x ∈ X; аналогично используется для обозначения диапазона параметра: x ∈ [0, 1].
Является ли Xi знаком класса? Нахождение xi в данных:
xi определено как знак класса!! Чтобы найти xi, выполните следующие шаги: Найдите верхний предел класса. … Вы получите оценку класса.
Что такое в Di XI A?
Следующий шаг — найти разницу di между a и каждым из xi, то есть отклонение «a» от каждого из xi. т.е., ди = хи – а = хи – 47.5. Третий шаг — найти произведение di на соответствующее fi и взять сумму всех fi di. Классовый интервал.
Что означает l в статистике?
В статистике L-статистика — это статистика (функция набора данных), которая линейная комбинация статистики заказов; «L» означает «линейный».
Что такое L в формуле медианы? Медиана = 2/2 + h / f [N / XNUMX — C] Здесь l = нижний предел среднего класса. h = размер класса, f = частота, соответствующая среднему классу. N = сумма частот.
Что такое ДФ в статистике? Степени свободы относятся до максимального количества логически независимых значений, которые являются значениями, которые могут изменяться в выборке данных. Степени свободы обычно обсуждаются в связи с различными формами проверки гипотез в статистике, такими как хи-квадрат.
Что такое 2 стандартное отклонение от среднего?
Стандартное отклонение говорит о разбросе данных. Это мера того, насколько каждое наблюдаемое значение отличается от среднего. В любом дистрибутиве около 95% значений будут быть в пределах 2 стандартных отклонений от среднего.
Что означают 2 стандартных отклонения от среднего? Стандартное отклонение является мерой вариации. Формула для стандартного отклонения: как видно выше, одно стандартное отклонение от среднего значения будет составлять 68% всех данных в нормальной модели, два стандартных отклонения от среднего значения будут составлять 95% данных.
Что означает стандартное отклонение 1.5?
На втором графике стандартное отклонение равно 1.5 балла, что опять же означает, что две трети учащихся набрали от 8.5 до 11.5 баллов (плюс-минус одно стандартное отклонение от среднего), а подавляющее большинство (95 процентов) набрали от 7 до 13 (два стандартных отклонения).
Как вы читаете эпсилон? Греческая буква эпсилон, обозначаемая как ϵ или ε, — это просто еще одна переменная, такая как x, n или T. Обычно она используется для обозначения небольшой величины, например ошибки, или, возможно, термина, который в некотором пределе будет обращен к нулю.
Означает ли Омега конец?
24-я и последняя буква греческого алфавита, омега (Ω), по сути, означает конец чего-то, последний, окончательный предел множества или «Великий конец». Не вдаваясь в урок греческого языка, Омега означает грандиозное завершение, как завершение масштабного события.
Что такое математическая статистика? Ди это отклонение переменной от центральной тенденции.
Как вы определяете размер класса?
Мы также знаем, что размер класса определяется как разница между фактическим верхним пределом и фактическим нижним пределом данного интервала класса. Следовательно, размер класса для интервала классов 10-20 составляет 10 человек.
Что такое классная отметка в статистике? Середина класса (или отметка класса) конкретная точка в центре ячеек (категорий) в таблице частотного распределения; Это также центр столбца гистограммы. … Средняя точка определяется как среднее значение верхнего и нижнего пределов класса.
Как найти среднее значение класса 11?
Есть два шага, чтобы найти среднее арифметическое в статистике: просуммируйте все числа, данные в наборе. а затем разделите его на общее количество предметов в вашем наборе. Среднее арифметическое находится аналогично выборочному среднему.
Как найти моду L?
Для сгруппированных данных формула режима задается как Мода = L + (f1−f02f1−f0−f2) ( f 1 — f 0 2 f 1 — f 0 — f 2 ) ч где L — нижняя граница модального класса, h — размер интервала классов, f1 f 1 — частота модального класса, f0 f 0 — частота класса, предшествующего модальному классу, f2 f 2 — частота модального класса. чай …
Что такое средний класс Класс 10? Медиана мера центральной тенденции, которая дает значение самого среднего наблюдения в данных. В случае несгруппированных данных мы сначала упорядочиваем значения данных наблюдений в порядке возрастания. Затем, если n нечетно, медианой является (n+1)/2-е наблюдение.
Как посчитать xi в статистике
Запрошуємо усіх хто любить цікаві задачі та головоломки відвідати групу! Зараз діє акція — підтримай студента! Знижки на роботи + безкоштовні консультації.
Контакты
Администратор, решение задач
Роман
Tel. +380685083397
[email protected]
skype, facebook:
roman.yukhym
Решение задач
Андрей
facebook:
dniprovets25
8.3. Средние величины в статистике
Наиболее распространенной формой статистических показателей, используемой в экономических исследованиях, являются средние показатели (средняя величина).
Средняя величина – представляет обобщенную количественную характеристику признака в статистической совокупности в конкретных условиях места и времени.
Показатель в форме средней величины выражает типичные черты и дает обобщающую характеристику однотипных явлений по одному из варьирующих признаков. Он отражает уровень этого признака, отнесенный к единице совокупности.
Важнейшее свойство средней величины заключается в том, что она отражает то общее, что присуще всем единицам исследуемой совокупности.
Значения признака отдельных единиц совокупности колеблются в ту или иную сторону под влиянием множества факторов, среди которых могут быть как основные, так и случайные.
- Например, курс акций корпорации в основном определяется финансовыми результатами ее деятельности. В то же время, в отдельные дни и на отдельных биржах эти акции в силу сложившихся обстоятельств могут продаваться по более высокому или заниженному курсу.
Сущность средней заключается, в том, что в ней взаимопогашаются отклонения значений признака отдельных единиц совокупности, обусловленные действием случайных факторов, и учитываются изменения, вызванные действием факторов основных. Это позволяет средней отражать типичный уровень признака и абстрагироваться от индивидуальных особенностей, присущих отдельным единицам.
ВИДЫ СРЕДНИХ ВЕЛИЧИН наиболее часто применяемых на практике:
- средняя арифметическая;
- средняя гармоническая;
- средняя геометрическая;
- средняя квадратическая.
Выбор средней величины зависит от содержания осредняемого признака и конкретных данных, по которым ее приходится вычислять.
- Средняя арифметическая простая (невзвешенная) – вычисляется когда каждый вариант совокупности встречается только один раз.
- Средняя арифметическая (взвешенная)–вариантыповторяютсяразличное число раз , при этом число повторений вариантов называется частотой, или статистическим весом.
ФОРМУЛЫ СРЕДНИХ ВЕЛИЧИН
- Средняя арифметическая простая – самый распространенный вид средней величины, рассчитывается по формуле (8.8):


- гдехi – вариант,аn – количество единиц совокупности.
- Пример вычисления средней арифметической простой. Провели опрос о желаемом размере заработной платы у пяти сотрудников офиса. По результатам опроса выяснили, что желаемый размер заработной платы составляет соответственно для каждого сотрудника: 50000, 100000, 200000, 350000, 500000 рублей человек. Рассчитаем среднюю арифметическую простую по формуле (8.8):Вывод: в среднем желаемый размер заработной платы по результатам опроса 5-ти человек составил 240 тысяч рублей.
- Средняя арифметическая взвешенная формула 8.9.
Дискретный вариационный ряд и его характеристики
Например:
Качественными признаками, которые не поддаются измерению, являются: профессия, пол, национальность и т.п.
Количественными признаками, которые можно подсчитать или измерить, являются: количество людей в группе, число повторений в опыте, возраст, вес, рост, скорость, температура и т.п.
Например:
Дискретными признаками, которые принимают отдельные значения, являются: количество людей в группе, число детей в семье, количество домов, число опытов и т.п.
Непрерывными признаками, которые могут принимать любые значения в интервале, являются: возраст, вес, рост, скорость, температура и т.п.
Распределение учеников по оценкам за контрольную работу
| Оценка, \(x_i\) | 2 | 3 | 4 | 5 | Всего |
| К-во учеников, \(f_i\) | 3 | 15 | 10 | 5 | 33 |
В данном ряду признак – это оценка, варианты признака \(x_i\) – это множество , частоты \(f_i\) – это количество учеников, получивших каждую из оценок.
п.2. Дискретный вариационный ряд, полигон частот и кумулята
| Варианты, \(x_i\) | \(x_1\) | \(x_2\) | . | \(x_k\) |
| Частоты, \(f_i\) | \(f_1\) | \(f_2\) | . | \(f_k\) |
Здесь k — число вариант исследуемого признака.
Тогда общее количество исходов (число единиц в совокупности): \(N=\sum_ ^k f_i\)
| Для распределения учеников по оценкам из нашего примера получаем такой полигон: |  |
Например:
Проведем необходимые расчеты и построим полигон относительных частот, кумуляту и эмпирическую функцию распределения учеников по оценкам.
| Оценка, \(x_i\) | 2 | 3 | 4 | 5 | Всего |
| К-во учеников, \(f_i\) | 3 | 15 | 10 | 5 | 33 |
| \(w_i\) | 0,0909 | 0,4545 | 0,3030 | 0,1515 | 1 |
| \(S_i\) | 0,0909 | 0,4545 | 0,8485 | 1 | — |
Полигон относительных частот (эмпирический закон распределения)
Кумулята (красная ломаная) и эмпирическая функция распределения (ступенчатая синяя кривая).
Эмпирическая функция распределения: $$ F(x)= \begin 0,\ x\leq 2\\ 0,0909,\ 2\lt x\leq 3\\ 0,5455,\ 3\lt x\leq 4\\ 0,8485,\ 4\lt x\leq 5\\ 1,\ x\gt 5 \end $$
п.3. Выборочная средняя, мода и медиана
На полигоне частот мода – это абсцисса самой высокой точки.
Медиана дискретного вариационного ряда – это значение варианты посредине упорядоченного ряда.
Алгоритм:
1. Отсортировать ряд по возрастанию.
2а. Если общее количество измерений N нечётное, найти \(m=\lceil\frac N2\rceil\) и округлить в сторону увеличения. \(M_e=x_m\) — искомая медиана.
2б. Если общее количество измерений N чётное, найти \(m=\frac N2\) и вычислить медиану как среднее \(M_e=\frac > \).
На графике кумуляты медиана – это абсцисса первой точки слева, ордината которой превысила 0,5.
Например:
1) Найдем выборочную среднюю для распределения учеников по оценкам:
| Оценка, \(x_i\) | 2 | 3 | 4 | 5 | Всего |
| К-во учеников, \(f_i\) | 3 | 15 | 10 | 5 | 33 |
| \(x_if_i\) | 6 | 45 | 40 | 25 | 116 |
$$ X_ =\frac =\frac \approx 3,5 $$ Средняя оценка за контрольную – 3,5.
2) Найдем моду. Максимальная частота – 15 человек – у троечников. Значит: \(M_o=3\).
3) Найдем медиану. Общее количество измерений N=33 — нечетное.
Находим: \(m=\lceil\frac N2\rceil=17\)
Смотрим на ряд слева направо. Сначала у нас идет 3 двоечника, затем 15 троечников.
Вместе их 18, и 17-й человек в ряду — троечник. Группа троечников является медианной: \(M_e=3\).
Также, медиану можно найти по графику кумуляты. (3;0,5455) – это первая слева точка, в которой ордината больше 0,5. Значит, медиана равна абсциссе этой точки, т.е. \(M_e=3\).
п.4. Степень асимметрии вариационного ряда
В рядах с асимметрией или выбросами выборочная средняя не отражает в полной мере особенности исследуемого признака. Типичный случай – значение среднего уровня доходов в странах с высоким индексом Джини, где 5% населения получает 95% доходов. Или анекдотичный случай со «средней температурой по больнице».
Поэтому, кроме средней, в статистическом исследовании всегда следует определять моду и медиану.
Например:
Для распределения учеников по оценкам мы получили \(X_ =3,5;\ M_o=3;\ M_e=3\).
Т.к. средняя оказалась больше моды и медианы, наше распределение имеет правостороннюю асимметрию (что видно на полигоне частот – правый хвост длиннее).
При этом \(\frac |> |>=\frac =1\lt 3\), т.е. распределение умеренно асимметрично.
п.5. Выборочная дисперсия и СКО
Например:
1) Найдем выборочную дисперсию для распределения учеников по оценкам:
| Оценка, \(x_i\) | 2 | 3 | 4 | 5 | Всего |
| К-во учеников, \(f_i\) | 3 | 15 | 10 | 5 | 33 |
| \(x_i^2\) | 4 | 9 | 16 | 25 | — |
| \(x_i^2 f_i\) | 12 | 135 | 160 | 125 | 432 |
$$ D=\frac -3,5^2=\frac -3,5^2\approx 0,73 $$ 2) Значение СКО: \(\sigma=\sqrt \approx 0,86\)
п.6. Исправленная выборочная дисперсия, стандартное отклонение выборки и коэффициент вариации
В теоретической статистике доказывается, что выборочная дисперсия D является смещенной оценкой дисперсии при распространении на генеральную совокупность.
А именно, выборочная дисперсия D всегда меньше математического ожидания для дисперсии генеральной совокупности.
Исправленная выборочная дисперсия S 2 является несмещенной оценкой.
Если показатель вариации V<33%, то выборка считается однородной, т.е. большинство полученных в ней вариант находятся недалеко от средней, и выборочная средняя хорошо характеризует среднюю генеральной совокупности.
В противном случае, выборка неоднородна. Варианты в выборке находятся далеко от средней, есть выбросы. А значит, и в генеральной совокупности они возможны. Т.е., распространять результаты выборки на генеральную совокупность нельзя.
Например:
Для распределения учеников по оценкам получаем:
1) Исправленная выборочная дисперсия $$ S^2=\frac D=\frac \cdot 0,73\approx 0,76 $$ 2) Стандартное отклонение $$ x=\sqrt \approx 0,87 $$ 3) Коэффициент вариации: $$ V=\frac \cdot 100\text \approx 24,8\text \lt 33\text $$ Выборка является однородной.
Это означает, что согласно коэффициенту вариации полученные результаты контрольной работы можно рассматривать в качестве «типичных» и распространить их на генеральную совокупность, т.е. на всех школьников, которые будут писать эту работу.
п.7. Алгоритм исследования дискретного вариационного ряда
На входе: таблица с вариантами \(x_i\) и частотами \(f_i,\ i=\overline \)
Шаг 1. Составить расчетную таблицу. Найти \(w_i,S_i,x_if_i,x_i^2,x_i^2f_i\)
Шаг 2. Построить полигон относительных частот (эмпирический закон распределения) и график кумуляты с эмпирической функцией распределения. Записать эмпирическую функцию распределения.
Шаг 3. Найти выборочную среднюю, моду и медиану. Проанализировать симметрию распределения.
Шаг 4. Найти выборочную дисперсию и СКО.
Шаг 5. Найти исправленную выборочную дисперсию, стандартное отклонение и коэффициент вариации. Сделать вывод об однородности выборки.
п.8. Примеры
Пример 1. На площадке фриланса была проведена выборка из 100 фрилансеров и подсчитано количество постоянных заказчиков, с которыми они работают.
В результате было получено следующее распределение:
| Число постоянных заказчиков | 0 | 1 | 2 | 3 | 4 | 5 |
| Число фрилансеров | 22 | 35 | 27 | 11 | 3 | 1 |
Исследуйте полученный вариационный ряд.
1) Вариационный ряд является дискретным.
Исследуемый признак – «число постоянных заказчиков».
Варианты признака \(x_i\in\left\ \). Количество вариант k=6.
Составим расчетную таблицу:
| \(x_i\) | 0 | 1 | 2 | 3 | 4 | 5 | ∑ |
| \(f_i\) | 23 | 35 | 27 | 11 | 3 | 1 | 100 |
| \(w_i\) | 0,23 | 0,35 | 0,27 | 0,11 | 0,03 | 0,01 | — |
| \(S_i\) | 0,23 | 0,58 | 0,85 | 0,96 | 0,99 | 1 | — |
| \(x_if_i\) | 0 | 35 | 54 | 33 | 12 | 5 | 139 |
| \(x_i^2\) | 0 | 1 | 4 | 9 | 16 | 25 | — |
| \(x_i^2f_i\) | 0 | 35 | 108 | 99 | 48 | 25 | 315 |
2) Полигон относительных частот (эмпирический закон распределения):
Кумулята и эмпирическая функция распределения:
$$ F(x)= \begin 0,\ x\leq 0\\ 0,23,\ 0\lt x\leq 1\\ 0,58,\ 1\lt x\leq 2\\ 0,85,\ 2\lt x\leq 3\\ 0,96,\ 3\lt x\leq 4\\ 0,99,\ 4\lt x\leq 5\\ 1,\ x\gt 5 \end $$ 3) Выборочная средняя: $$ X_ =\frac1N\sum_ ^k x_if_i= \frac \cdot 139=1,39 $$ Мода (абсцисса самой высокой точки на полигоне частот): \(M_0=1\).
Медиана (абсцисса первой слева точки на кумуляте, где значение превысило 0,5): точка (1;0,58), \(M_e=1\).
\(X_ \gt M_e=M_0\) – распределение асимметрично, с правосторонней асимметрией.
При этом \(\frac |> |>=\frac =1\lt 3\), т.е. распределение умеренно асимметрично.
4) Выборочная дисперсия: $$ D=\frac1N\sum_ ^k x_i^2f_i-X_ ^2=\frac \cdot 315-1,39^2=1,2179\approx 1,218 $$ CKO: $$ \sigma=\sqrt \approx 1,104 $$
5) Исправленная выборочная дисперсия: $$ S^2=\frac D=\frac \cdot 1,218\approx 1,230 $$ Стандартное отклонение выборки: $$ s=\sqrt \approx 1,109 $$ Коэффициент вариации: $$ V=\frac >\cdot 100\text =\frac \cdot 100\text \approx 79,8\text \gt 33\text $$ Представленная выборка неоднородна. Полученное значение средней \(X_ =1,39\) не может быть распространено на генеральную совокупность всех фрилансеров.