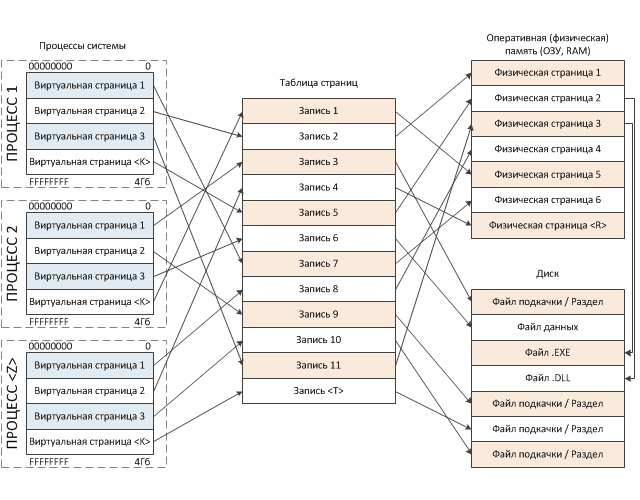
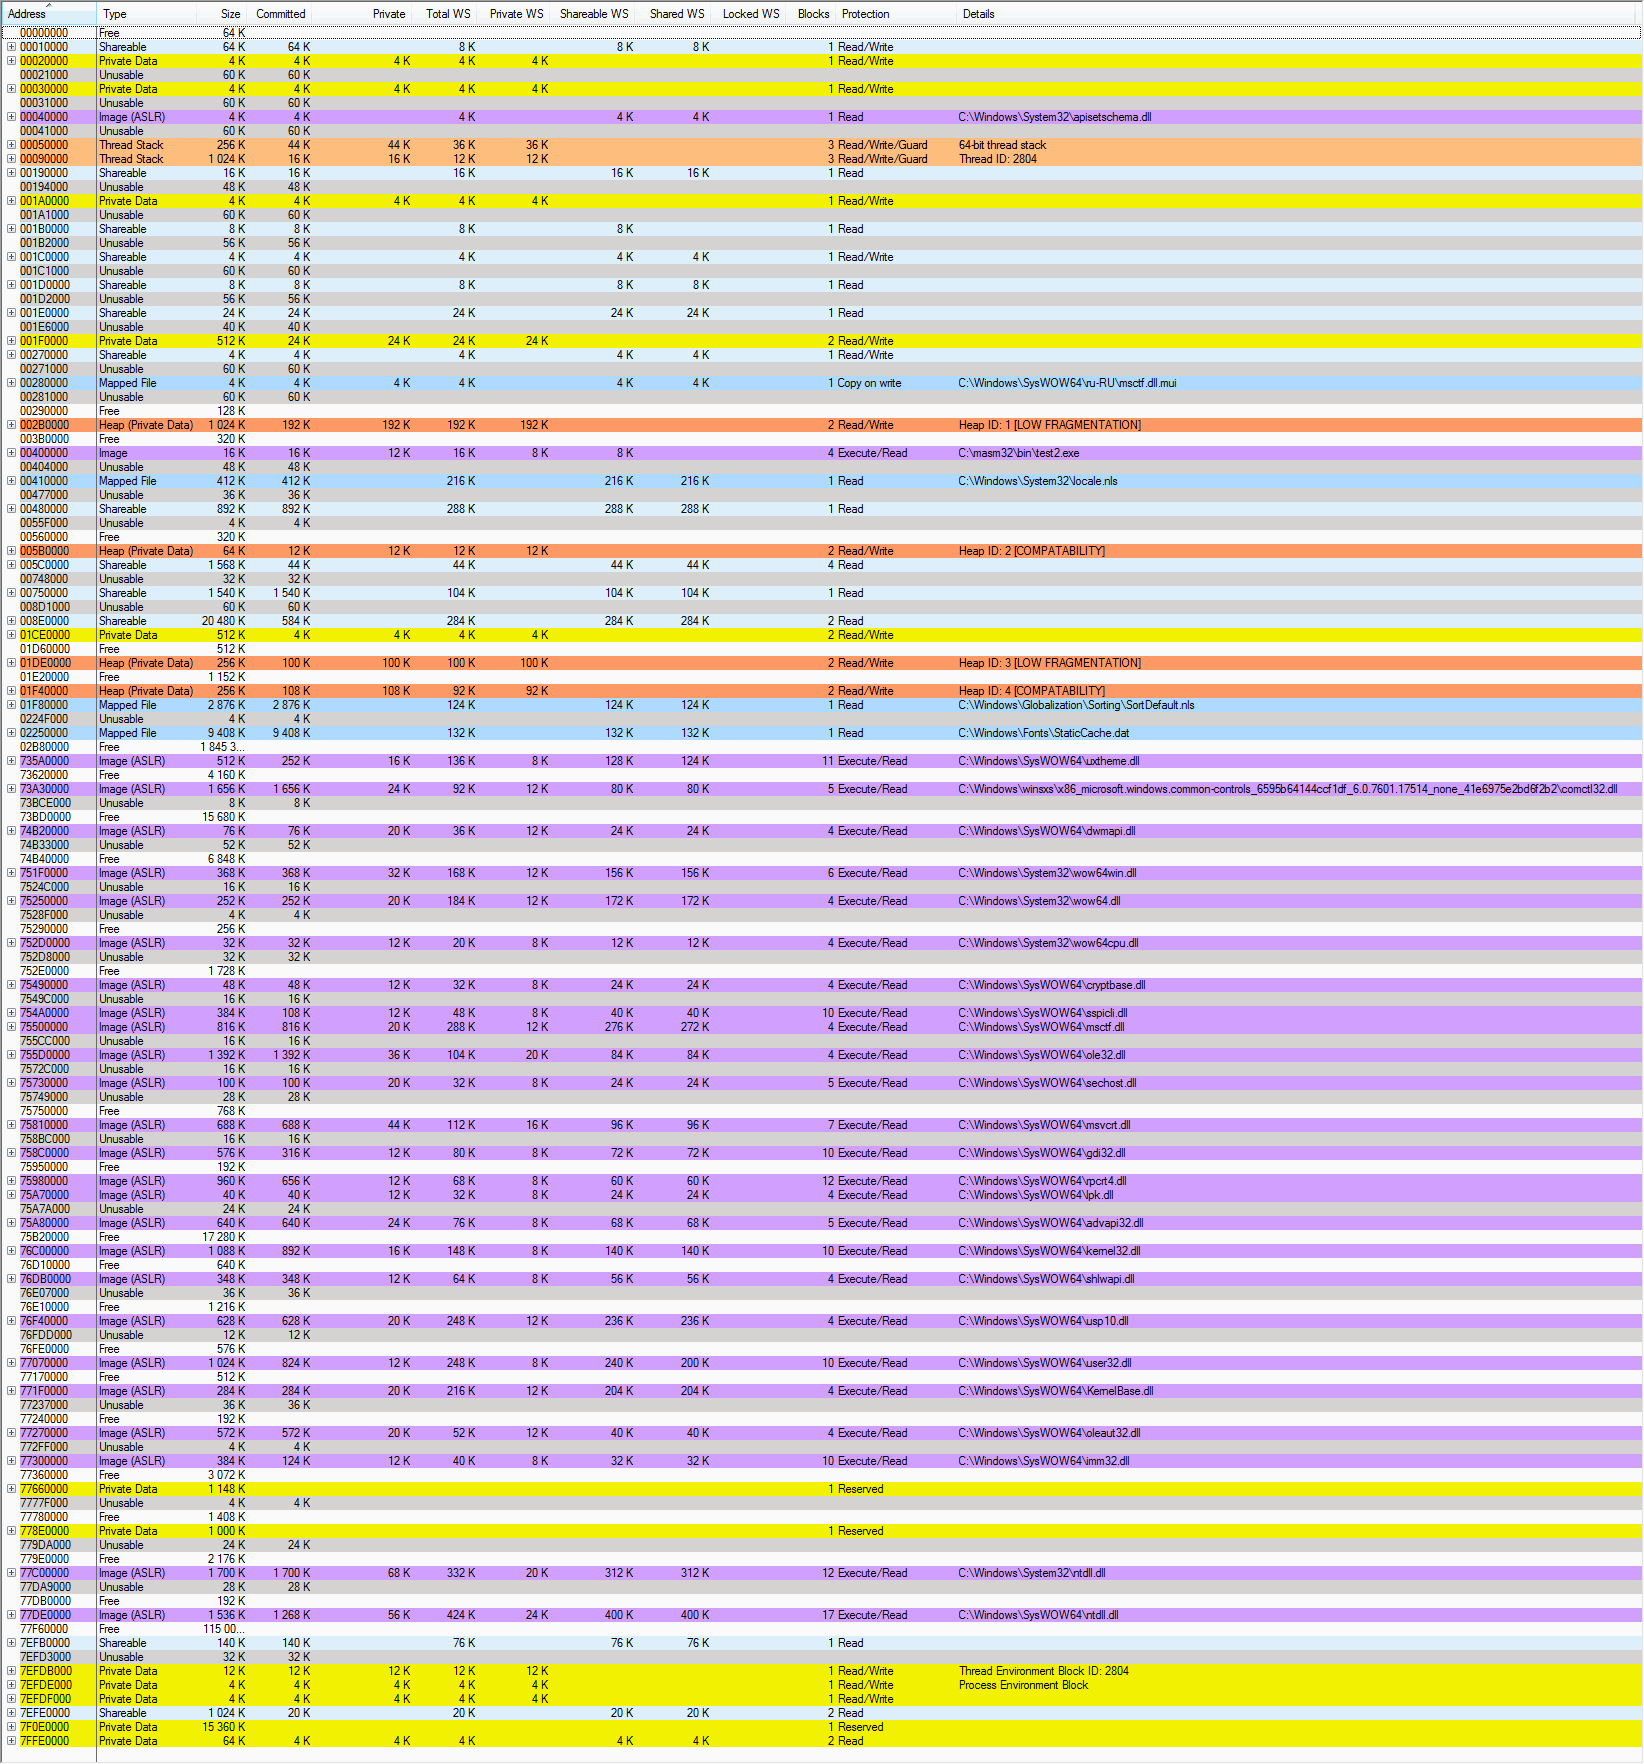
Большинство программистов представляют вычислительную систему как процессор, который выполняет инструкции, и память, которая хранит инструкции и данные для процессора. В этой простой модели память представляется линейным массивом байтов и процессор может обратиться к любому месту в памяти за константное время. Хотя это эффективная модель для большинства ситуаций, она не отражает того, как в действительности работают современные системы.
В действительности система памяти образует иерархию устройств хранения с разными ёмкостями, стоимостью и временем доступа. Регистры процессора хранят наиболее часто используемые данные. Маленькие быстрые кэш-памяти, расположенные близко к процессору, служат буферными зонами, которые хранят маленькую часть данных, расположеных в относительно медленной оперативной памяти. Оперативная память служит буфером для медленных локальных дисков. А локальные диски служат буфером для данных с удалённых машин, связанных сетью.
Иерархия памяти работает, потому что хорошо написанные программы имеют тенденцию обращаться к хранилищу на каком-то конкретном уровне более часто, чем к хранилищу на более низком уровне. Так что хранилище на более низком уровне может быть медленнее, больше и дешевле. В итоге мы получаем большой объём памяти, который имеет стоимость хранилища в самом низу иерархии, но доставляет данные программе со скоростью быстрого хранилища в самом верху иерархии.
Как программист, вы должны понимать иерархию памяти, потому что она сильно влияет на производительность ваших программ. Если вы понимаете как система перемещает данные вверх и вниз по иерархии, вы можете писать такие программы, которые размещают свои данные выше в иерархии, так что процессор может получить к ним доступ быстрее.
В этой статье мы исследуем как устройства хранения организованы в иерархию. Мы особенно сконцентрируемся на кэш-памяти, которая служит буферной зоной между процессором и оперативно памятью. Она оказывает наибольшее влияние на производительность программ. Мы введём важное понятие локальности, научимся анализировать программы на локальность, а также изучим техники, которые помогут увеличить локальность ваших программ.
На написание этой статьи меня вдохновила шестая глава из книги Computer Systems: A Programmer’s Perspective. В другой статье из этой серии, «Оптимизация кода: процессор», мы также боремся за такты процессора.
Память тоже имеет значение
Рассмотрим две функции, которые суммируют элементы матрицы. Они практически одинаковы, только первая функция обходит элементы матрицы построчно, а вторая — по столбцам.
Обе функции выполняют одно и то же количество инструкций процессора. Но на машине с Core i7 Haswell первая функция выполняется в 25 раз быстрее для больших матриц. Этот пример хорошо демонстрирует, что память тоже имеет значение. Если вы будете оценивать эффективность программ только в терминах количества выполняемых инструкций, вы можете писать очень медленные программы.
Данные имеют важное свойство, которое мы называем локальностью. Когды мы работаем над данными, желательно чтобы они находились в памяти рядом. Обход матрицы по столбцам имеет плохую локальность, потому что матрица хранится в памяти построчно. О локальности мы поговорим ниже.
Иерархия памяти
Современная система памяти образует иерархию от быстрых типов памяти маленького размера до медленных типов памяти большого размера. Мы говорим, что конкретный уровень иерархии кэширует или является кэшем для данных, расположенных на более низком уровне. Это значит, что он содержит копии данных с более низкого уровня. Когда процессор хочет получить какие-то данные, он их сперва ищет на самых быстрых высоких уровнях. И спускается на более низкие, если не может найти.
На вершине иерархии находятся регистры процессора. Доступ к ним занимает 0 тактов, но их всего несколько штук. Далее идёт несколько килобайт кэш-памяти первого уровня, доступ к которой занимает примерно 4 такта. Потом идёт пара сотен килобайт более медленной кэш-памяти второго уровня. Потом несколько мегабайт кэш-памяти третьего уровня. Она гораздо медленней, но всё равно быстрее оперативной памяти. Далее расположена относительно медленная оперативная память.
Оперативную память можно рассматривать как кэш для локального диска. Диски это рабочие лошадки среди устройств хранения. Они большие, медленные и стоят дёшево. Компьютер загружает файлы с диска в оперативную память, когда собирается над ними работать. Разрыв во времени доступа между оперативной памятью и диском колоссальный. Диск медленнее оперативной памяти в десятки тысяч раз, и медленнее кэша первого уровня в миллионы раз. Выгоднее обратиться несколько тысяч раз к оперативной памяти, чем один раз к диску. На это знание опираются такие структуры данных, как B-деревья, которые стараются разместить больше информации в оперативной памяти, пытаясь избежать обращения к диску любой ценой.
Локальный диск сам может рассматриваться как кэш для данных, расположенных на удалённых серверах. Когда вы посещаете веб-сайт, ваш браузер сохраняет изображения с веб-страницы на диске, чтобы при повторном посещении их не нужно было качать. Существуют и более низкие иерархии памяти. Крупные датацентры, типа Google, сохраняют большие объёмы данных на ленточных носителях, которые хранятся где-то на складах, и когда понадобятся, должны быть присоеденены вручную или роботом.
Современная система имеет примерно такие характеристики:
Тип кэша
Время доступа (тактов)
Размер кэша
Регистры
0
десятки штук
L1 кэш
4
32 KB
L2 кэш
10
256 KB
L3 кэш
50
8 MB
Оперативная память
200
8 GB
Буфер диска
100’000
64 MB
Локальный диск
10’000’000
1000 GB
Удалённые сервера
1’000’000’000
∞
Быстрая память стоит очень дорого, а медленная очень дёшево. Это великая идея архитекторов систем совместить большие размеры медленной и дешёвой памяти с маленькими размерами быстрой и дорогой. Таким образом система может работать на скорости быстрой памяти и иметь стоимость медленной. Давайте разберёмся как это удаётся.
Допустим, ваш компьютер имеет 8 ГБ оперативной памяти и диск размером 1000 ГБ. Но подумайте, что вы не работаете со всеми данными на диске в один момент. Вы загружаете операционную систему, открываете веб-браузер, текстовый редактор, пару-тройку других приложений и работаете с ними несколько часов. Все эти приложения помещаются в оперативной памяти, поэтому вашей системе не нужно обращаться к диску. Потом, конечно, вы закрываете одно приложение и открываете другое, которое приходится загрузить с диска в оперативную память. Но это занимает пару секунд, после чего вы несколько часов работаете с этим приложением, не обращаясь к диску. Вы не особо замечаете медленный диск, потому что в один момент вы работаете только с небольшим бъёмом данных, которые кэшируются в оперативной памяти. Вам нет смысла тратить огромные деньги на установку 1024 ГБ оперативной памяти, в которую можно было бы загрузить содержимое всего диска. Если бы вы это сделали, вы бы почти не заметили никакой разницы в работе, это было бы «деньги на ветер».
Так же дело обстоит и с маленькими кэшами процессора. Допустим вам нужно выполнить вычисления над массивом, который содержит 1000 элементов типа int. Такой массив занимает 4 КБ и полностью помещается в кэше первого уровня размером 32 КБ. Система понимает, что вы начали работу с определённым куском оперативной памяти. Она копирует этот кусок в кэш, и процессор быстро выполняет действия над этим массивом, наслаждаясь скоростью кэша. Потом изменённый массив из кэша копируется назад в оперативную память. Увеличение скорости оперативной памяти до скорости кэша не дало бы ощутимого прироста в производительности, но увеличило бы стоимость системы в сотни и тысячи раз. Но всё это верно только если программы имеют хорошую локальность.
Локальность
Локальность — основная концепция этой статьи. Как правило, программы с хорошей локальностью выполняются быстрее, чем программы с плохой локальностью. Локальность бывает двух типов. Когда мы обращаемся к одному и тому же месту в памяти много раз, это временнáя локальность. Когда мы обращаемся к данным, а потом обращаемся к другим данным, которые расположены в памяти рядом с первоначальными, это пространственная локальность.
Рассмотрим, программу, которая суммирует элементы массива:
В этой программе обращение к переменным sum и i происходит на каждой итерации цикла. Они имеют хорошую временную локальность и будут расположены в быстрых регистрах процессора. Элементы массива A имеют плохую временную локальность, потому что к каждому элементу мы обращаемся только по разу. Но зато они имеют хорошую пространственную локальность — тронув один элемент, мы затем трогаем элементы рядом с ним. Все данные в этой программе имеют или хорошую временную локальность или хорошую пространственную локальность, поэтому мы говорим что программа в общем имеет хорошую локальность.
Когда процессор читает данные из памяти, он их копирует в свой кэш, удаляя при этом из кэша другие данные. Какие данные он выбирает для удаления тема сложная. Но результат в том, что если к каким-то данным обращаться часто, они имеют больше шансов оставаться в кэше. В этом выгода от временной локальности. Программе лучше работать с меньшим количеством переменных и обращаться к ним чаще.
Перемещение данных между уровнями иерархии осуществляется блоками определённого размера. К примеру, процессор Core i7 Haswell перемещает данные между своими кэшами блоками размером в 64 байта. Рассмотрим конкретный пример. Мы выполняем программу на машине с вышеупомянутым процессором. У нас есть массив v, содержащий 8-байтовые элементы типа long. И мы последовательно обходим элементы этого массива в цикле. Когда мы читаем v[0], его нет в кэше, процессор считывает его из оперативной памяти в кэш блоком размером 64 байта. То есть в кэш отправляются элементы v[0]–v[7]. Далее мы обходим элементы v[1], v[2], . v[7]. Все они будут в кэше и доступ к ним мы получим быстро. Потом мы читаем элемент v[8], которого в кэше нет. Процессор копирует элементы v[8]–v[15] в кэш. Мы быстро обходим эти элементы, но не находим в кэше элемента v[16]. И так далее.
Поэтому если вы читаете какие-то байты из памяти, а потом читаете байты рядом с ними, они наверняка будут в кэше. В этом выгода от пространственной локальности. Нужно стремиться на каждом этапе вычисления работать с данными, которые расположены в памяти рядом.
Желательно обходить массив последовательно, читая его элементы один за другим. Если нужно обойти элементы матрицы, то лучше обходить матрицу построчно, а не по столбцам. Это даёт хорошую пространственную локальность. Теперь вы можете понять, почему функция matrixsum2 работала медленнее функции matrixsum1. Двумерный массив расположен в памяти построчно: сначала расположена первая строка, сразу за ней идёт вторая и так далее. Первая функция читала элементы матрицы построчно и двигалась по памяти последовательно, будто обходила один большой одномерный массив. Эта функция в основном читала данные из кэша. Вторая функция переходила от строки к строке, читая по одному элементу. Она как бы прыгала по памяти слева-направо, потом возвращалась в начало и опять начинала прыгать слева-направо. В конце каждой итерации она забивала кэш последними строками, так что в начале следующей итерации первых строк кэше не находила. Эта функция в основном читала данные из оперативной памяти.
Дружелюбный к кэшу код
Как программисты вы должны стараться писать код, который, как говорят, дружелюбный к кэшу (cache-friendly). Как правило, основной объём вычислений производится лишь в нескольких местах программы. Обычно это несколько ключевых функций и циклов. Если есть вложенные циклы, то внимание нужно сосредоточить на самом внутреннем из циклов, потому что код там выполняется чаще всего. Эти места программы и нужно оптимизировать, стараясь улучшить их локальность.
Вычисления над матрицами очень важны в приложениях анализа сигналов и научных вычислениях. Если перед программистами встанет задача написать функцию перемножения матриц, то 99.9% из них напишут её примерно так:
Этом код дословно повторяет математическое определение перемножения матриц. Мы обходим все элементы окончательной матрицы построчно, вычисляя каждый из них один за другим. В коде есть одна неэффективность, это выражение B[k][j] в самом внутреннем цикле. Мы обходим матрицу B по стобцам. Казалось бы, ничего с этим не поделаешь и придётся смириться. Но выход есть. Можно переписать то же вычисление по другому:
Теперь функция выглядит очень странно. Но она делает абсолютно то же самое. Только мы не вычисляем каждый элемент окончательной матрицы за раз, мы как бы вычисляем элементы частично на каждой итерации. Но ключевое свойство этого кода в том, что во внутреннем цикле мы обходим обе матрицы построчно. На машине с Core i7 Haswell вторая функция работает в 12 раз быстрее для больших матриц. Нужно быть действительно мудрым программистом, чтобы организовать код таким образом.
Блокинг
Существует техника, которая называется блокинг. Допустим вам надо выполнить вычисление над большим объёмом данных, которые все не помещаются в кэше высокого уровня. Вы разбиваете эти данные на блоки меньшего размера, каждый из которых помещается в кэше. Выполняете вычисления над этими блоками по отдельности и потом объёдиняете результат.
Можно продемонстрировать это на примере. Допустим у вас есть ориентированный граф, представленный в виде матрицы смежности. Это такая квадратная матрица из нулей и единиц, так что если элемент матрицы с индексом (i, j) равен единице, то существует грань от вершины графа i к вершине j. Вы хотите превратить этот ориентированный граф в неориентированный. То есть, если есть грань (i, j), то должна появиться противоположная грань (j, i). Обратите внимание, что если представить матрицу визуально, то элементы (i, j) и (j, i) являются симметричными относительно диагонали. Эту трансформацию нетрудно осуществить в коде:
Блокинг появляется естественным образом. Представьте перед собой большую квадратную матрицу. Теперь иссеките эту матрицу горизонтальными и вертикальными линиями, чтобы разбить её, скажем, на 16 равных блока (четыре строки и четыре столбца). Выберите два любых симметричных блока. Обратите внимание, что все элементы в одном блоке имеют свои симметричные элементы в другом блоке. Это наводит на мысль, что ту же операцию можно совершать над этими блоками поочерёдно. В этом случае на каждом этапе мы будем работать только с двумя блоками. Если блоки сделать достаточно маленького размера, то они поместятся в кэше высокого уровня. Выразим эту идею в коде:
Нужно заметить, что блокинг не улучшает производительность на системах с мощными процессорами, которые хорошо делают предвыборку. На системах, которые не делают предвыборки, блокинг может сильно увеличить производительность.
На машине с процессором Core i7 Haswell вторая функция не выполняется быстрее. На машине с более простым процессором Pentium 2117U вторая функция выполняется в 2 раза быстрее. На машинах, которые не выполняют предвыборку, производительность улучшилась бы ещё сильнее.
Какие алгоритмы быстрее
Все знают из курсов по алгоритмам, что нужно выбирать хорошие алгоритмы с наименьшей сложностью и избегать плохих алгоритмов с высокой сложностью. Но эти сложности оценивают выполнение алгоритма на теоретической машине, созданной нашей мыслью. На реальных машинах теоретически плохой алгоритм может выполнятся быстрее теоретически хорошего. Вспомните, что получить данные из оперативной памяти занимает 200 тактов, а из кэша первого уровня 4 такта — это в 50 раз быстрее. Если хороший алгоритм часто трогает память, а плохой алгоритм размещает свои данные в кэше, хороший алгоритм может выполняться медленнее плохого. Также хороший алгоритм может выполняться на процессоре хуже, чем плохой. К примеру, хороший алгоритм вносит зависимость данных и не может загрузить конвеер процессора. А плохой алгоритм лишён этой проблемы и на каждом такте отправляет в конвеер новую инструкцию. Иными словами, сложность алгоритма это ещё не всё. Как алгоритм будем выполняться на конкретной машине с конкретными данными имеет значение.
Представим, что вам нужно реализовать очередь целых чисел, и новые элементы могут добавляться в любую позицию очереди. Вы выбираете между двумя реализациями: массив и связный список. Чтобы добавить элемент в середину массива, нужно сдвинуть вправо половину массива, что занимает линейное время. Чтобы добавить элемент в середину списка, нужно дойти по списку до середины, что также занимает линейное время. Вы думаете, что раз сложности у них одинаковые, то лучше выбрать список. Тем более у списка есть одно хорошее свойство. Список может расти без ограничения, а массив придётся расширять, когда он заполнится.
Допустим, очередь длиной 1000 элементов мы реализовали обоими способами. И нам нужно вставить элемент в середину очереди. Элементы списка хаотично разбросаны по памяти, поэтому чтобы обойти 500 элементов, нам понадобится 500*200=100’000 тактов. Массив расположен в памяти последовательно, что позволит нам наслаждаться скоростью кэша первого уровня. Используя несколько оптимизаций, мы можем двигать элементы массива, тратя 1-4 такта на элемент. Мы сдвинем половину массива максимум за 500*4=2000 тактов. То есть быстрее в 50 раз.
Если в предыдущем примере все добавления были бы в начало очереди, реализация со связным списком была бы более эффективной. Если какая-то доля добавлений была бы куда-то в середину очереди, реализация в виде массива могла бы стать лучшим выбором. Мы бы тратили такты на одних операциях и экономили такты на других. И в итоге могли бы остаться в выигрыше.
Заключение
Система памяти организована в виде иерархии устройств хранения с маленькими и быстрыми устройствами вверху иерархии и большими и медленными устройствами внизу. Программы с хорошей локальностью работают с данными из кэшей процессора. Программы с плохой локальностью работают с данными из относительно медленной оперативной памяти.
Программисты, которые понимают природу иерархии памяти, могут структурируют свои программы так, чтобы данные располагались как можно выше в иерархии и процессор получал их быстрее.
Размещение объектов в оперативной памяти. Понятие указателя
Язык C++ по меркам сегодняшнего дня является языком программирования относительно низкого уровня. В частности, он не берёт на себя в полной мере управление таким важным ресурсом компьютера, как оперативная память. Поэтому крайне важно при изучении основ программирования на этом языке составить правильное представление об организации оперативной памяти, предоставляемой программам, и о базовых принципах работы с ней.
Знание основ управления памятью будет полезным и при использовании других языков программирования.
Оперативная память
С точки зрения разработчика программного обеспечения оперативная память представляет собой упорядоченную последовательность ячеек — байт, предназначенных для размещения данных, которыми оперирует программа во время своего выполнения.
Упорядоченность означает, что каждый элемент последовательности (каждая ячейка памяти) имеет свой порядковый номер. Этот порядковый номер называют адресом ячейки памяти — адресом байта. Непрерывный диапазон ячеек, доступный для адресации в конкретной операционной системе, называют адресным пространством .
Схематично память обычно представляют так, как показано на рис. 1.
Рис. 1. Адресное пространство
Байты упорядочивают снизу вверх, указанные в ячейках числа — это номера ячеек, являющиеся их адресами. Начальные адреса памяти часто называют младшими или нижними, а конечные — старшими или верхними.
Общее количество доступных для адресации ячеек памяти определяется разрядностью операционной системы, более точно — разрядностью типа данных, используемого в конкретной операционной системе для хранения номера ячейки.
Современные операционные системы в своём большинстве представлены 32- и 64-разрядными версиями. В 32-разрядных операционных системах для работы с номерами ячеек памяти используются 32-разрядные (4-байтные) типы данных. Адресовать в таких системах можно до 4294967296 ячеек — максимальное число, которое можно представить 32 разрядами, что в точности соответствует 4 Гб адресного пространства. В 64-разрядных операционных системах для работы с номерами ячеек памяти используются 64-разрядные (8-байтные) типы данных. Количество ячеек, которое можно адресовать в таких системах, измеряется эксабайтами. В дальнейшем для большей определённости мы будем предполагать, что работа ведётся в 32-разрядной операционной системе.
В итоге, с каждой ячейкой памяти связано две величины — порядковый номер ячейки, называемый адресом, и данные, которые хранятся в ячейке по этому адресу.
Представление объектов в оперативной памяти, указатели
Все объекты, которые каким-либо образом определяются в программе, размещаются в оперативной памяти. Рассмотрим следующую небольшую программу на языке C++:
В первых двух строчках функции main
определяются переменные i и j , являющиеся объектами целочисленного типа int , которые инициализируются значениями 17 и 29 соответственно. При выполнении этих строк кода в памяти выделяются ячейки под хранение значений переменных i и j или, иными словами, под размещение объектов i и j , в которые записываются начальные значения 17 и 29.
На рис. 2 показано состояние памяти после выполнения рассматриваемых строк кода.
Рис. 2. Размещение в памяти объектов i и j
Для определенности будем считать, что объект с именем i размещен в памяти, начиная с 48-ой ячейки.
ПРИМЕЧАНИЕ
Следует отметить, что память (доступное программе адресное пространство) разбивается на разделы (непрерывные диапазоны ячеек), часть из которых резервируется под нужды операционной системы. Так, в операционных системах Microsoft Windows младшие адреса памяти используются для выявления нулевых указателей, в связи с чем вероятность встретить в программе объект, расположенный по адресу 48, близка к нулю. Однако на данном этапе в целях упрощения изложения и исключения операций с большими числами мы не будем принимать этот факт во внимание.
Не лишним будет сказать, что одной из лучших книг, описывающих архитектуру памяти Windows, является книга Джеффри Рихтера «Windows для профессионалов» [7].
Количество ячеек памяти, необходимое для размещения объекта (необходимое для хранения состояния объекта), определяется типом объекта. Объектам целочисленного типа достаточно 4 ячеек — 4 байт. Таким образом, объект i занимает 4 ячейки — с 48-й по 51-ю включительно, в этих ячейках хранится число 17.
Можно сказать по-другому: данные, расположенные в памяти с 48-й по 51-ю ячейку, известны в нашей программе под именем i и интерпретируются как целое число.
Следом за объектом i располагается объект j . Он также является объектом типа int , а следовательно, тоже занимает 4 ячейки — с 52-й по 55-ю, в этих ячейках хранится число 29.
Номер первой из занимаемых объектом ячеек памяти называют адресом объекта . Так, адресом объекта i будет число 48, а объекта j — число 52.
Адрес объекта является той характеристикой, которая идентифицирует объект, отличает один объект от всех других объектов в системе.
Рассмотрим следующую строчку нашей программы:
Здесь определяется переменная p1 , являющаяся указателем (pointer) на объект типа int , которая инициализируется адресом объекта i . Указатели — это особый вид объектов , предназначенных для хранения информации о местоположении в памяти других объектов.
Значением объекта-указателя является адрес другого объекта.
О том, что p1 является указателем, говорит символ ‘*’, следующий непосредственно за названием типа. Указатели типизированы: при определении объекта-указателя задается тип объектов, на которые он может указывать — значением объекта-указателя может быть только адрес объекта соответствующего типа. Так, указателю на объект типа int может быть присвоен только адрес объекта типа int , указателю на объект типа double — только адрес объекта типа double и т. п. В нашем случае p1 может указывать только на объекты типа int ; значением p1 может быть только адрес объекта типа int . Компилятор не позволит (выдав соответствующее сообщение об ошибке) присвоить переменной p1 адрес объекта, не относящегося к типу int .
Символ ‘&’, предшествующий переменной i , обозначает операцию взятия адреса . Унарная префиксная операция взятия адреса обеспечивает переход от объекта к его адресу. В нашем случае она возвращает адрес объекта i , которым инициализируется переменная p1 .
Часто операцию взятия адреса также называют операцией получения адреса .
Адрес объекта, как отмечалось ранее, — это номер ячейки, начиная с которой объект размещается в памяти. Объект i размещается в памяти, начиная с 48-й ячейки, следовательно, его адресом является число 48, оно же является значением объекта-указателя p1 . На рис. 3 показана конфигурация памяти после выполнения рассматриваемой строчки программы.
Рис. 3. Размещение в памяти объектов i, j и p1
Объекты-указатели, равно как и любые другие объекты, размещаются в памяти, занимая в ней определённое количество ячеек. Поскольку объект-указатель хранит адрес другого объекта, а адрес — это номер ячейки памяти, то, независимо от типа (а, следовательно, и размера) объекта, на который указывает объект-указатель, сам объект-указатель в 32-разрядных операционных системах всегда занимает в памяти 4 ячейки — 4 байта.
В нашем случае объект p1 занимает ячейки с 56-й по 59-ю, в этих ячейках хранится число 48, являющееся номером ячейки, начиная с которой в памяти размещён объект i .
Распечатаем теперь значение переменной p1 :
ПРИМЕЧАНИЕ
endl — сокращение от end line — манипулятор стандартного потока вывода, записывающий в него символ перевода строки ‘\n’ и форсирующий отображение информации на экране.
Мы вполне можем ожидать, что данный код выведет на экран число 48, однако… будет выведено число 00000030. Дело в том, что при работе с адресами ячеек памяти (а, следовательно, с адресами объектов и значениями объектов-указателей) принято использовать шестнадцатеричную систему счисления.
Шестнадцатеричная система удобна. В этой системе значение любого байта может быть записано посредством двух шестнадцатеричных цифр, а так как под хранение адреса ячейки памяти отводится 4 байта, то любой адрес может быть компактно представлен восемью шестнадцатеричными цифрами. Перевод чисел из двоичной системы счисления в шестнадцатеричную и обратно выполняется крайне просто. Кроме того, отображение (равно как и запись) адресов ячеек памяти в шестнадцатеричной системе счисления позволяет визуально отличать их от значений целочисленных переменных.
ПРИМЕЧАНИЕ
Для перевода числа из двоичной системы счисления в шестнадцатеричную следует двоичные цифры объединить в группы по четыре в направлении справа налево и заменить каждую группу соответствующей шестнадцатеричной цифрой.
Обратный перевод выполняется аналогичным образом: каждую шестнадцатеричную цифру нужно заменить её представлением в двоичной системе, дополненном, при необходимости, лидирующими нулями до 4 разрядов.
Обоснование данного правила можно найти в книге Джеймса Андерсона «Дискретная математика и комбинаторика» [12].
Вернёмся к примеру. Число 48 является суммой пятой и четвёртой степеней двойки; в двоичной системе счисления ему соответствует число 110000, которое, в соответствии с приведённым выше правилом перевода, в шестнадцатеричной системе записывается как 30, что, за исключением шести лидирующих нулей, в точности соответствует выводу нашей программы. Лидирующие нули используются для достижения единого восьмизначного формата отображения адресов памяти — младшие адреса памяти, представляемые меньшим количеством знаков, дополняются ими до 8 разрядов.
Так как далеко не все шестнадцатеричные числа содержат в своей записи буквенные символы, то для того, чтобы явно показать, что число представлено в шестнадцатеричной системе счисления, непосредственно перед ним часто ставят префикс ’0x’.
На рис. 4 показана рассмотренная ранее конфигурация памяти в более общепринятом виде (лидирующие нули, в целях упрощения картины, опущены).
Рис. 4
ПРИМЕЧАНИЕ
Говоря о размещении объектов в оперативной памяти, необходимо сказать о существовании нескольких моделей представления в памяти многобайтных объектов, таких, например, как объекты типа int. Основными являются модели little-endian и big-endian.
В модели little-endian запись числа начинается с младшего байта и заканчивается старшим. Такой порядок записи чисел принят на архитектурах x86.
В модели big-endian запись числа начинается со старшего байта и заканчивается младшим. Такой порядок является стандартным для сетевых протоколов TCP/IP.
Например, число 29 (в шестнадцатеричной системе счисления — 0x1D), являясь значением объекта типа int (занимающим в памяти 4 байта), в модели little-endian будет представлено последовательностью байт со значениями 1D, 00, 00, 00; в модели big-endian — последовательностью байт со значениями 00, 00, 00, 1D.
Преимуществом модели little-endian является возможность преобразования типов целых чисел при чтении меньшего количества байт. Так, прочитав значение 0x0000001D объекта типа int как данные объекта типа short, т. е. только первые два байта, мы получим число 0x001D, прочитав это же значение как данные объекта типа char, т. е. только первый байт, мы получим число 0x1D.
Для записи больших чисел, длина которых существенно превышает разрядность машины, также предпочтительнее порядок little-endian, поскольку арифметические операции над числами производятся от младших разрядов к старшим.
Числа, представленные в модели big-endian, выглядят естественным для арабской записи чисел образом.
Следующая строчка программы
демонстрирует переход от указателя на объект к объекту, на который данный указатель указывает. В отличие от рассмотренной ранее строки, выводящей на экран значение непосредственно переменной p1 , эта строчка распечатывает состояние объекта, на который переменная p1 указывает — результатом её выполнения будет вывод на экран числа 17.
В данном контексте символ ‘*’, предшествующий p1 , обозначает операцию разыменования . Унарная префиксная операция разыменования обеспечивает переход от указателя на объект к объекту, расположенному в памяти по адресу, хранимому в указателе. Операция разыменования становится возможной исключительно в силу типизации указателей: в типе заложена информация о размере памяти, необходимой для размещения объекта, и о способе интерпретации содержащихся в ней данных, что в совокупности с адресом однозначно идентифицирует объект в памяти.
В нашем случае p1 — это указатель на объект целочисленного типа int , значением p1 является число 0x30. Следовательно, применяемая к p1 операция разыменования возвращает объект, расположенный в памяти начиная с ячейки с номером 0x30, занимающий в ней 4 байта, относящийся к типу int , т. е. объект, известный в нашей программе под именем i . Значением объекта, соответственно, будет число 17 — именно оно находится в четырех ячейках памяти, на которые указывает p1 (рис. 5).
Рис. 5
ПРИМЕЧАНИЕ
В некотором смысле, операция разыменования * является обратной по отношению к операции взятия адреса & — для произвольного объекта d любого наперёд заданного типа, поддерживающего операцию сравнения, выражение *&d == d всегда истинно.
Используя операцию разыменования, мы можем не только получать значение адресуемого указателем объекта (в частности, для вывода на экран), но и изменять это значение – например, так, как это делается в следующей строке нашей программы:
Здесь выполняется присваивание нового значения объекту, на который указывает p1 . Сначала, при помощи операции разыменования, осуществляется переход от указателя p1 к объекту, адрес которого хранится в p1 , после чего полученному объекту присваивается новое значение — в ячейки памяти, отведённые под этот объект, записывается число 103. Как мы знаем, p1 указывает на объект i , следовательно, приведённый код модифицирует данные в ячейках памяти, занимаемых объектом i , изменяя тем самым состояние объекта i .
На рис. 6 показана конфигурация памяти после выполнения рассматриваемой инструкции.
Рис. 6
Вывод на экран значения объекта i
приведёт теперь к отображению числа 103, что полностью подтверждает наши рассуждения — мы изменили состояние объекта через указатель на него.
Таким образом, используя указатель p1 (и операцию разыменования), мы можем производить над объектом i в точности те же самые действия, что и с использованием имени i . Следовательно, p1 можно трактовать как ещё одно имя объекта i . Подобные имена называют косвенными . В итоге у нас есть один целочисленный объект и два его имени: прямое — i и косвенное — p1 , посредством которых можно обращаться к этому объекту — получать или изменять его состояние.
Косвенных имён может быть и больше. Так, в следующей строке нашей программы создаётся ещё одно косвенное имя — p2 , при помощи которого мы можем работать с объектом i .
ПРИМЕЧАНИЕ
Смысл символа ‘*’ зависит от контекста, в котором он используется. При определении переменной (int* p;) он говорит о том, что определяемая переменная будет указателем; при использовании в префиксной форме (*p) он обозначает операцию разыменования указателя; в инфиксной форме (например, в выражении 5 * 7) символ ‘*’ обозначает операцию умножения.
В строке кода выше определяется указатель p2 на объект типа int , который инициализируется значением указателя p1 — числом 0x30 — адресом объекта i (рис. 7). Тем самым, p2 становится ещё одним указателем на объект i , ещё одним именем, позволяющим косвенно обращаться к объекту i .
Рис. 7. Размещение в памяти объектов i, j, p1 и p2
Итак, у нас есть целочисленный объект с именем i и два объекта-указателя с именами p1 и p2 , которые указывают на объект i . Т.е. p1 и p2 , с одной стороны, являются именами объектов-указателей, а с другой — косвенными именами объекта i ; применив к этим именам операцию разыменования, мы получим доступ к одному и тому же объекту — объекту i .
К примеру, следующий код
по аналогии с рассмотренным ранее, производит запись числа 107 в ячейки памяти, отведённые под объект, адрес которого хранится в указателе p2 , т. е. в ячейки памяти, занимаемые объектом i . Здесь, как и ранее, мы изменяем состояние объекта i через указатель на него, но теперь делаем это с помощью переменной p2 .
Состояние памяти после выполнения данного кода показано на рис. 8.
Рис. 8
i, *p1, *p2 обозначают один объект. Гради Буч в своей книге «Объектно-ориентированный анализ и проектирование с примерами приложений на C++» [11] отмечает, что «источником множества ошибок в объектно-ориентированном программировании является неумение отличать имя объекта от самого объекта».
Распечатав значение объекта i и значение объекта, на который указывает p1:
мы получим один и тот же результат — число 107, так как именно оно теперь является значением объекта i и именно на него указывают переменные p1 и p2 .
Рассмотрим обратную ситуацию — присвоим новое значение непосредственно объекту i .
Выполнение этого кода (см. рис. 9) напрямую скажется на результатах последующего разыменования указателей p1 и p2 .
В обоих случаях на экран будет выведено число 207: посредством имён i , p1 и p2 мы прямо или косвенно обращаемся к одному и тому же объекту в памяти, поэтому воздействие на объект через одно из этих имён незамедлительно отражается на результате, получаемом через любое другое имя.
Рис. 9
При необходимости указатель на один объект всегда можно превратить в указатель на другой объект соответствующего типа. К примеру, сделаем из p2 (указателя на объект i ) указатель на объект j . Для этого достаточно переменной p2 присвоить адрес объекта j .
ПРИМЕЧАНИЕ
Результатом применения операции взятия адреса & к объекту типа int будет объект типа int* и наоборот, результатом применения к объекту типа int* операции разыменования * будет объект типа int .
Рис. 10 иллюстрирует состояние памяти после выполнения приведённой строки кода.
Рис. 10
В данном случае (перед p2 нет символа ‘*’) осуществляется присваивание нового значения непосредственно объекту-указателю p2 — в отведённые под него ячейки памяти записывается адрес объекта j — число 0x34, тем самым изменяется состояние p2 — он становится указателем на объект j.
Если теперь распечатать значение объекта, адресуемого указателем p2
то на экран будет выведено число 29, то есть значение объекта j .
ПРИМЕЧАНИЕ
У объекта-указателя, равно как и у любого другого объекта, есть адрес — номер ячейки, начиная с которой объект-указатель располагается в памяти. Так, адресом объекта-указателя p1 является число 0x38, объекта-указателя p2 — число 0x3C. Получить адрес объекта-указателя можно посредством применения к нему операции взятия адреса &. Результатом применения этой операции к указателю на объект типа int (к объекту типа int* ) будет объект типа int** .
В большинстве случаев сложности при работе с указателями возникают вследствие двойственности их природы: можно работать с адресом, являющимся значением указателя, а можно с объектом, расположенным по этому адресу.
Лучшему пониманию происходящего в программе (а также при проектировании того, что должно в ней происходить) помогает схематичное отображение (на обычной бумаге, обычной ручкой) состояния объектов и связей между ними, подобно тем схемам, что были приведены при разборе нашего примера. Схемы визуально показывают какой указатель на какой объект указывает, что чему присваивается, что происходит при выполнении той или иной операции с точки зрения размещения объектов в памяти. Восприятие визуальных образов происходит гораздо легче и быстрее.
ПРИМЕЧАНИЕ
Для полноты картины следует сказать о возможности определения нетипизированных указателей. Нетипизированные указатели определяются как указатели на void :
Указателю на void можно присвоить адрес объекта любого типа (значение указателя на объект любого типа). Операция разыменования к указателям на void не применима, поскольку при отсутствии информации о типе нет информации о размере адресуемого указателем объекта и о способе интерпретации данных этого объекта. Чтобы получить доступ к объекту, адрес которого хранит нетипизированный указатель, необходимо выполнить явное преобразование типа указателя (преобразование типов объектов осуществляется посредством функций static_cast , const_cast , reinterpret_cast и dynamic_cast ).
Используются указатели на void , в основном в функциях, оперирующих не объектами, а непосредственно областями памяти ( malloc , free , realloc и т. п.).
Как отмечает Бьерн Страуструп в своей книге «Язык программирования C++» [1] (это основная книга по языку), «функции, использующие void* , обычно существуют на самых нижних уровнях системы, где происходит работа с аппаратными ресурсами. Наличие void* на более высоких уровнях подозрительно и, скорее всего, является индикатором ошибки на этапе проектирования».
Динамическая память и стек
В общем случае оперативная память, с которой работает программа, подразделяется на три вида: статическую, автоматическую и динамическую.
Статическая память — это область памяти, выделяемая при запуске программы до вызова функции main из свободной оперативной памяти для размещения глобальных и статических объектов, а также объектов, определённых в пространствах имён.
Объект называют глобальным , если он определён вне функции, класса или пространства имён. Объект, определённый с использованием ключевого слова static , называют статическим .
Глобальные объекты, а также объекты, определённые в пространствах имён или статически в классах, размещаются в памяти (конструируются) до вызова функции main , а разрушаются после завершения работы этой функции.
Пространства имён — это способ разделения программы на логические составляющие; механизм ограничения области видимости имён.
Автоматическая память — это специальный регион памяти, резервируемый при запуске программы до вызова функции main из свободной оперативной памяти и используемый в дальнейшем для размещения локальных объектов: объектов, определяемых в теле функций и получаемых функциями через параметры в момент вызова. Автоматическую память часто называют стеком .
Динамическая память — это совокупность блоков памяти, выделяемых из доступной свободной оперативной памяти непосредственно во время выполнения программы под размещение конкретных объектов.
ПРИМЕЧАНИЕ
Регионом, областью или блоком памяти называют непрерывную последовательность ячеек памяти. Обычно регион больше области, а область больше блока.
Далее мы сосредоточим внимание на подходах к организации автоматической и динамической памяти и на принципах работы с этими видами памяти.
Автоматическая память (стек)
Непосредственное управление автоматической памятью — выделение памяти под локальные объекты при их создании и освобождение занимаемой объектами памяти при их разрушении — осуществляется компилятором. Собственно, по этой причине память и называют автоматической.
Посмотрим, какие закономерности характерны для размещаемых в автоматической памяти объектов, и почему данный вид памяти также называют стеком.
Период времени от момента создания объекта до момента его разрушения, т. е. период времени, в течение которого под объект выделена память, называют временем жизни объекта .
Время жизни локальных объектов определяется областью видимости их имён. Область видимости локального имени начинается с места его объявления и заканчивается в конце блока, в котором это имя объявлено. Область видимости аргументов функции ограничивается телом функции, т. е. считается, что имена аргументов объявлены в самом внешнем блоке функции.
ПРИМЕЧАНИЕ
Область видимости имени — это часть текста программы, в рамках которой имя может быть использовано.
Таким образом, время жизни локального объекта начинается в процессе выполнения функции в момент определения объекта и заканчивается в момент выхода процесса выполнения из блока, обрамляющего это определение.
Обрабатывая определение локального имени, такого как i , j , p1 и p2 из рассмотренного ранее примера, компилятор генерирует код размещения соответствующего ему объекта в регионе автоматической памяти: код выделения памяти под объект и вызова конструктора для инициализации выделенной памяти.
Обрабатывая завершение блока (закрывающую фигурную скобку ‘>’) компилятор генерирует код разрушения всех объектов, определённых в этом блоке: код вызова деструкторов и освобождения занимаемой объектами памяти. В случае с нашим примером компилятор на месте фигурной скобки, завершающей тело функции main , сгенерирует код разрушения объектов p2 , p1 , j и i , т. е. всех объектов, чьи имена в данном месте выходят из области видимости.
Учитывая вложенность вызовов функций, а также вложенность блоков внутри функций можно говорить о вложенности времён жизни локальных объектов: время жизни объектов, созданных позже, заканчивается раньше. Это, в свою очередь, позволяет сделать вывод о том, что размещение объектов в автоматической памяти и их удаление из неё происходит по принципу LIFO.
ПРИМЕЧАНИЕ
LIFO — сокращение от Last In First Out — принцип обслуживания элементов в порядке, обратном их поступлению — первым обслуживается (извлекается) элемент, пришедший последним.
Программным воплощением данного принципа является стек, который и используется в большинстве компиляторов C++ для реализации автоматической памяти. Именно вследствие такой реализации (такого внутреннего устройства) автоматическую память часто называют стеком, а локальные объекты — стековыми. В дальнейшем этого названия будем придерживаться и мы.
Еще раз вернёмся к нашему примеру. Все те объекты, размещение которых в оперативной памяти мы рассматривали, т. е. i , j , p1 и p2 , являясь локальными объектами, размещаются не абстрактно в оперативной памяти, а в конкретном её регионе — стеке. Рис. 11 иллюстрирует это, отражая состояние стека непосредственно перед выходом из функции main .
Рис. 11. Регион автоматической памяти — стек
Объекты в стеке размещаются последовательно друг за другом в порядке их определения (см. рис. 11). Выделение памяти в стеке в общих чертах сводится к смещению указателя вершины стека в направлении роста стека на размер размещаемого объекта; освобождение памяти — к смещению указателя вершины стека в обратном направлении на размер удаляемого объекта (помните о вложенности времён жизни локальных объектов). Операции выделения и освобождения памяти в стеке выполняются очень быстро.
ПРИМЕЧАНИЕ
1. Порядок расположения в автоматической памяти объектов, определяемых в теле функций, в отличие от порядка расположения объектов, передаваемых функциям через параметры, никак не регламентируется и остаётся на усмотрение разработчиков компиляторов. По этой причине он может отличаться от рассмотренного выше и изменяться от одной версии компилятора к другой. Более того, некоторые локальные объекты могут размещаться компилятором в регистрах процессора.
Объекты, передаваемые через параметры функции, по умолчанию закладываются в стек в порядке, обратном их перечислению в списке параметров.
2. На архитектурах x86 стек растет в сторону уменьшения адресов памяти, т. е. вниз.
В итоге, размещение объектов в стеке могло бы быть таким, как показано на рис. 12.
Однако указанные замечания не имеют существенного значения для понимания сути рассматриваемых концепций, в связи с чем, мы не станем, в дальнейшем, акцентировать на них внимание и будем придерживаться первоначальной модели стека.
Рис. 12. Размещение объектов в стеке на архитектурах x86
Размещение объектов в стеке имеет неоспоримые преимущества. Прежде всего, в силу автоматического разрушения объектов: нам не нужно заботиться об удалении стековых объектов, это делает за нас компилятор, генерируя на выходе локального имени из области видимости код разрушения соответствующего ему объекта — код вызова деструктора и освобождения отведённой (в стеке) под объект памяти. Существенное значение имеет и высокая скорость размещения объектов в стеке.
Однако специфика работы со стеком накладывает и определённые ограничения — далеко не все объекты могут быть в нём размещены. Стратегия автоматического удаления не позволит нам создать в функции стековый объект, время жизни которого превышало бы время выполнения функции. Из того, что выделение памяти в стеке возлагается на компилятор, следует, что размер (а значит и тип) размещаемых в стеке объектов должен быть известен на этапе компиляции, что часто бывает невозможно. Простейшая задача обработки массива, размерность и элементы которого вводятся с клавиатуры или из файла, является ярким тому подтверждением. Кроме того, размер стека в большинстве случаев ограничен (для программ, разрабатываемых в среде Microsoft Visual Studio, размер стека по умолчанию — 1 Мб), что приводит к невозможности размещения в нём больших объектов, к примеру, тех же массивов. Средством преодоления рассмотренных ограничений является динамическая память, особенностям работы с которой посвящен следующий раздел.
Динамическая память
Доступную программе свободную оперативную память часто, в связи со спецификой размещения в ней объектов, называют кучей (heap). В общем случае нет чёткого, наперёд заданного (как в стеке) порядка расположения объектов в ней: распределение блоков памяти происходит динамически — в большинстве реализаций под объект отводится первый подходящий по размеру свободный блок. Вследствие этого динамическую память часто определяют как память, выделяемую из кучи (непосредственно во время выполнения программы под размещение конкретных объектов).
В отличие от стека, которым управляет компилятор, управление динамической памятью осуществляется явным образом: выделение памяти производится оператором new , освобождение — оператором delete (C++, конечно же, поддерживает работу с памятьюв стиле С, например, с помощью функций malloc и free, но для целей данной статьи это несущественно – прим.ред.) .
Рассмотрим работу с динамической памятью на примере небольшой программы:
Программа состоит из двух функций: main , с которой начинается выполнение любой C++-программы, и CreateObject . Функция CreateObject создаёт в динамической памяти объект типа int и возвращает указатель на него. Функция main вызывает функцию CreateObject , получает указатель на созданный ею объект, производит с этим объектом некоторую работу, после чего разрушает его. Исследуем процесс выполнения этой программы.
В первой строчке функции main:
определяется переменная p1 , являющаяся указателем на объект целочисленного типа int , которая инициализируется предопределённым значением NULL.
NULL — это специальное значение, используемое для идентификации объектов-указателей, которые ни на что не указывают; оно соответствует нулевому адресу и обычно определяется одним из следующих способов:
ПРИМЕЧАНИЕ
В C++0х введена новая константа – nullptr, специально предназначенная для обозначения нулевого указателя – прим.ред.
Гарантируется, что в программе (в системе) не может быть объектов с нулевым адресом, следовательно, объект-указатель со значением 0 можно интерпретировать как указатель, который ничего не адресует. Такие объекты-указатели называют нулевыми указателями . Значение NULL или 0 может быть присвоено указателю на объект любого типа. Разыменование нулевого указателя приводит к неопределённому поведению программы, в большинстве случаев — к её аварийному завершению.
При выполнении рассматриваемой строки кода в оперативной памяти, более точно — в стеке, выделяются ячейки под размещение объекта-указателя p1 , в эти ячейки записывается число 0 — p1 ни на что не указывает. Рис. 13 отражает состояние памяти (с учётом её разделения на регионы) после выполнения данной строки кода.
Рис. 13. Куча и стек
Как и ранее, для большей определённости, будем считать, что объект-указатель p1 размещён в стеке по адресу 0x30, т.е. занимает с 48-й по 51-ю ячейки памяти.
ПРИМЕЧАНИЕ
В дальнейшем на схемах мы будем отображать только значимые для нас области стека и кучи.
Перейдем к следующей строке функции main :
В этой строке осуществляется вызов функции CreateObject и сохранение возвращаемого ею значения в переменной p1 . При вызове функции CreateObject выполнение функции main приостанавливается и процесс выполнения переходит к первой строчке функции CreateObject :
Данная строка программы представляет для нас наибольший интерес, поскольку мы начинаем работать с динамической памятью. В этой строке определяется локальный объект-указатель p , который инициализируется адресом нового, создаваемого оператором new в динамической памяти целочисленного объекта со значением 309.
Формат вызова оператора new таков: ключевое слово «new», за которым следует тип создаваемого объекта, за которым в круглых скобках может следовать список параметров, необходимых для начальной инициализации объекта.
Что делает оператор new ? Во-первых, он выделяет память в куче. Для этого на основе информации о типе оператор new вычисляет количество ячеек памяти, необходимое для размещения объекта этого типа, и обращается к системе, более точно — к диспетчеру памяти, с запросом о предоставлении блока памяти рассчитанного размера. Во-вторых, он вызывает конструктор — специальный метод создаваемого объекта, выполняющий на основе переданных в круглых скобках параметров начальную инициализацию полученной памяти. Возвращаемым значением оператора new является адрес созданного объекта.
ПРИМЕЧАНИЕ
В целом действия, производимые оператором new , напоминают те, что выполняет компилятор при создании локальных объектов, с той разницей, что оператор new выделяет память в куче, а под локальные объекты память выделяется в стеке. После выделения памяти в обоих случаях происходит её инициализация посредством вызова конструктора. Вызов конструктора завершает создание объекта.
Возникает два вопроса: что подразумевается под термином «выделение памяти» (или «предоставление памяти») и что произойдет, если диспетчер памяти не сможет выделить блок требуемого размера?
У диспетчера памяти (его также называют менеджером памяти) есть список выделенных (иначе говоря, занятых) и свободных блоков памяти. Получив запрос от оператора new , он просматривает этот список в поисках первого свободного блока достаточного размера. Обнаружив такой блок, диспетчер памяти проверяет, равен ли его размер тому, что был запрошен, или превосходит его. Если равен, то диспетчер памяти помечает найденный блок как занятый (выделенный под размещение объекта) и возвращает адрес этого блока оператору new . Если же размер найденного блока больше запрашиваемого, то диспетчер памяти отделяет от него блок требуемого размера, разбивая тем самым исходный блок на два, помечает полученный блок как занятый и возвращает его адрес оператору new .
После того как блок памяти помечен диспетчером как занятый, он закрепляется за создаваемым объектом и не может быть отдан под размещение какого-либо другого объекта до тех пор, пока мы явно не освободим его (вызовом оператора delete ).
Бывают случаи, когда диспетчер памяти не может найти свободный блок требуемого размера. Ранее, до появления в стандарте C++ исключений (exceptions), в таких случаях оператор new возвращал значение NULL. С появлением исключений поведение оператора new было изменено — теперь при нехватке памяти он генерирует исключение std::bad_alloc .
ПРИМЕЧАНИЕ
К моменту включения в стандарт исключений и соответствующего изменения работы оператора new , на языке C++ было реализовано огромное количество программных систем, поэтому в целях поддержки существующего кода многие современные компиляторы имеют специальную настройку, позволяющую выбирать между двумя возможными вариантами поведения оператора new . Однако пользоваться этой настройкой и включать устаревшее поведение при разработке новых проектов не рекомендуется — это отрицательно скажется как на переносимости кода, так и его читаемости. Для тех же ситуаций, когда у вас найдутся веские причины избегать использования исключений, предусмотрен специальный формат вызова оператора new :
new(std::nothrow) type (args)
Константа std::nothrow , указанная в круглых скобках непосредственно за ключевым словом «new», явно говорит о том, что в случае нехватки памяти оператор new вместо генерации исключения std::bad_alloc должен вернуть значение NULL (type и args, как и в общем случае, — тип создаваемого объекта и возможные параметры его инициализации).
Оператор new , в тех случаях, когда конструктор создаваемого им объекта генерирует исключение, выполняет освобождение выделенной ранее памяти.
Вернёмся к рассматриваемой нами строке программы:
Конфигурация памяти после её выполнения представлена на рис. 14.
Рис. 14
Для определённости будем считать, что созданный оператором new объект располагается в оперативной памяти (в куче) по адресу 0xF830, т. е. занимает в ней с 63536 по 63539 ячейки включительно.
ПРИМЕЧАНИЕ
Куча и стек — это разные регионы адресного пространства, часто расположенные на значительном удалении друг от друга, в связи с чем адреса объектов, размещённых в куче, обычно весьма существенно отличаются от адресов объектов, размещённых в стеке.
Оператор new создаёт в куче объект типа int со значением 309 и возвращает адрес этого объекта — число 0xF830. Компилятор создаёт в стеке объект-указатель p и инициализирует его адресом, возвращённым оператором new — в ячейки памяти, отведённые в стеке под p , записывается число 0xF830.
В итоге рассматриваемая строчка порождает в памяти два (это важно, обратите особое внимание) объекта: объект целочисленного типа int со значением 309 в куче и объект-указатель p в стеке. Адрес созданного в куче объекта является значением стекового объекта-указателя p (см. рис. 14).
Как мы знаем по результатам разбора первого примера, указатель на объект можно трактовать как косвенное имя адресуемого им объекта. Однако если в случае с указателем на стековый объект мы можем обратиться к объекту как посредством указателя, так и прямого имени, то в случае с указателем на объект в куче прямого имени, такого как i или j , в нашем распоряжении нет. С объектом в куче мы можем работать (получать или изменять его состояние) только посредством указателей.
Вывод на экран значения переменной p
в условиях наших допущений об адресе созданного оператором new объекта приведёт ко вполне ожидаемому результату — отображению шестнадцатеричного числа 0000F830.
В следующей строке
завершается выполнение функции CreateObject . Из неё в функцию main возвращается значение 0xF830 — адрес динамически созданного целочисленного объекта со значением 309.
При выходе процесса выполнения из функции все определённые в этой функции локальные объекты разрушаются, отведённая под их размещение память освобождается, указатель вершины стека смещается вниз, занимая то положение, в котором он находился до вызова функции. С завершением работы функции CreateObject перестаёт существовать объект-указатель p , однако адресуемый им объект, созданный оператором new в куче, остаётся. Этот объект не является стековым и, следовательно, на выходе из функции компилятор не генерирует код его разрушения. Адрес этого объекта, являясь возвращаемым значением функции CreateObject , присваивается в функции main локальной переменной p1 :
Рис. 15 отражает состояние оперативной памяти после выполнения приведённой выше строки кода.
Рис. 15
Распечатав значение объекта-указателя p1
мы убеждаемся в том, что оно в точности совпадает со значением, которое было у разрушенного к этому моменту объекта-указателя p функции CreateObject . p1 — новое косвенное имя динамически созданного в функции CreateObject объекта, посредством p1 мы можем работать с этим объектом в функции main .
В следующей строке функции main , непосредственно перед тем, как начать работу с адресуемым указателем p1 объектом, выполняется проверка допустимости операции разыменования:
ПРИМЕЧАНИЕ
В C++ значение выражения считается истинным, если оно отлично от нуля. Таким образом, данный оператор проверяет, не равно ли значение указателя p1 NULL.
Вообще говоря, в рамках разбираемого примера данная проверка необязательна. В случае недостаточного количества памяти оператор new сгенерирует исключение, после чего — учитывая, что мы это исключение нигде не обработали — наша программа аварийно завершится; до рассматриваемой строки процесс выполнения просто не дойдет. Но такая проверка необходима, если предположить, что функция CreateObject самостоятельно обрабатывает исключение std::bad_alloc и в случае его возникновения возвращает значение NULL; либо, что в функции CreateObject по каким-либо причинам использовалась nothrow-версия оператора new ; либо, что функция CreateObject относится к сторонней библиотеке, в документации к которой сказано, что при невозможности создания объекта данная функция возвращает значение NULL и т.п.
Проверив указатель p1 на возможность разыменования, мы распечатываем значение адресуемого им объекта:
В результате выполнения этого кода на экран будет выведено число 309 (см. рис. 15) — то самое число, которым в функции CreateObject проинициализирован динамически создаваемый объект.
Далее динамически созданному объекту присваивается новое значение:
При этом совершаются те же действия, что и при задании через указатель нового значения стековому объекту. Сначала, посредством операции разыменования, осуществляется переход от указателя p1 к объекту, адрес которого хранится в p1 , после чего полученному объекту присваивается новое значение — в ячейки памяти, отведённые под этот объект, записывается число 517.
Состояние памяти после выполнения данной строки программы показано на рис. 16.
Рис. 16
Как видите, при работе с объектом через указатель нет разницы, в каком конкретно регионе памяти этот объект размещён: в стеке или в куче — доступ к объекту для получения или изменения его состояния выполняется одинаково.
В заключительной строчке функции main удаляется адресуемый указателем p1 объект:
Оператор delete производит действия, в точности обратные тем, что совершает оператор new при создании объекта, а именно: вызывает деструктор — специальную функцию деинициализации разрушаемого объекта, после чего освобождает память , занимаемую объектом в куче.
ПРИМЕЧАНИЕ
Вызов конструктора уведомляет создаваемый объект о том, что память под него выделена и её необходимо проинициализировать — записать в неё начальные значения. Деструктор — функция, парная конструктору. Вызов деструктора уведомляет разрушаемый объект о том, что процесс его удаления начат и объекту необходимо освободить те ресурсы, которые были им захвачены во время жизни.
Для освобождения памяти оператор delete (как и оператор new ) обращается к диспетчеру памяти, передаёт ему адрес удаляемого объекта и сообщает, что работа с областью памяти, занимаемой этим объектом, завершена. Диспетчер памяти выполняет всю работу по освобождению памяти.
Таким образом, удаление объекта из памяти означает, что память, отведённая под хранение его данных, перестает быть закреплённой за этим объектом — она возвращается системе и может быть отдана ею под размещение данных другого объекта.
В нашем случае оператор delete возвращает системе блок памяти, начинающийся с ячейки 0xF830 — адреса удаляемого объекта — значения указателя p1 . На рис. 17 показано состояние памяти после выполнения рассматриваемой строки кода.
Рис. 17
О том, какие данные будут храниться в диапазоне ячеек памяти 0xF830–0xF833 после выполнения оператора delete , мы достоверно знать не можем: если система ещё не успела отдать этот блок памяти под размещение какого-либо объекта, в них по-прежнему будет число 517, если успела — некие новые данные.
ПРИМЕЧАНИЕ
В большинстве случаев непосредственно в момент удаления объекта из памяти — из кучи или из стека — с данными, содержащимися в отведённых под этот объект ячейках, ничего не происходит. Но эти ячейки перестают быть закреплёнными за объектом (поскольку логически объект больше не существует), они становятся свободными, доступными для размещения других объектов. И вот тогда, когда эти ячейки будут отданы под размещение нового объекта, хранимая в них информация будет затёрта данными нового объекта.
Надо обратить внимание на то, что при удалении адресуемого указателем p1 объекта с самим указателем p1 , с его значением ничего не происходит . Оператор delete освобождает память в куче, указатель же p1 располагается в стеке, отведённая под него память будет освобождена только при выходе p1 из области видимости. В ячейках памяти, занимаемых указателем p1 в стеке (см. рис. 17), после выполнения оператора delete будет записана та же информация, что и до вызова этого оператора — число 0xF830 — адрес уже несуществующего объекта.
В нашем примере никаких дополнительных действий не требуется, так как выполнение функции завершается на следующей после вызова оператора delete строке, и указатель p1 будет автоматически разрушен.
ПРИМЕЧАНИЕ
Допускается применение оператора delete к нулевому указателю (указателю со значением NULL). В этом случае оператор delete ничего не делает и сразу возвращает управление в вызывающую функцию.
Управление динамической памятью является важнейшей стороной программирования на C++. Работая с динамической памятью, мы вплотную сталкиваемся с указателями, понимание природы которых позволяет избежать огромного количества ошибок. Как написал Джоэл Спольски в своей новой книге «Джоэл: и снова о программировании» [10]: «Указатели и рекурсия требуют определённых способностей к рассуждению и абстрактному мышлению, а главное — умения рассматривать проблему на нескольких уровнях абстракции одновременно. Поэтому способность разобраться в указателях и рекурсии непосредственно связана с перспективой стать выдающимся программистом».
Полезные упражнения
Наберите рассмотренную программу в редакторе среды программирования, например, в Microsoft Visual Studio. Запустите её под отладчиком, в режиме пошагового выполнения посмотрите на значения и адреса объектов. Поэкспериментируйте с программой: попробуйте два раза подряд вызвать оператор удаления для одного и того же указателя или разыменовать нулевой указатель, посмотрите на поведение программы в каждом из случаев.
Отслеживание утечек памяти
Необходимость явного управления временем жизни, а точнее, своевременного удаления динамических объектов, вызывает основные сложности при работе с ними. Когда объект, созданный оператором new , становится более не нужным, он должен быть удален оператором delete . В противном случае память, закреплённая за этим объектом, так и останется занятой (не будет возвращена системе) — диспетчер памяти не будет учитывать её при размещении других объектов. Потеря всех указателей на динамический объект (по завершении их времени жизни или при присваивании им новых значений) приведёт к тому, что освобождение занимаемой объектом памяти станет невозможным — возникнет утечка памяти (memory leak).
Библиотеки, входящие в Microsoft Visual C++, предоставляют механизм отслеживания утечек памяти, позволяющий диагностировать их наличие в программе и способствующий обнаружению в коде программы мест их возникновения.
Суть механизма в следующем. В отладочной версии программы (т. е. при её сборке в конфигурации Debug) функции и операторы выделения и освобождения памяти в куче подменяются их специальными отладочными версиями, которые, в дополнение к непосредственно выделению и освобождению памяти, ведут учёт выделяемых программой блоков памяти. Например, отладочные функции выделения памяти при каждом своём вызове могут помещать в некий глобальный список запись с информацией о выделенном блоке памяти: адрес блока, размер блока, имя файла, в котором осуществлен вызов функции, номер строки в нём и пр. Отладочные функции освобождения памяти, соответственно, могут удалять из этого списка ту запись, которая описывает освобождаемый блок.
Перед самым завершением выполнения программы на основе результатов работы отладочных функций выделения и освобождения памяти (например, если список выделенных блоков памяти не пуст) формируется отчёт по выделенным, но не освобождённым блокам, который отображается в окне Output среды разработки. Этот отчёт для каждого не освобождённого блока включает: номер блока, имя файла и номер строки в этом файле, содержащей вызов функции выделения памяти, адрес блока, его размер и значение начальных ячеек (при двойном щелчке мышью по имени файла осуществляется переход к строке этого файла, содержащей вызов функции выделения памяти). При отсутствии утечек памяти отчёт не выводится.
Подключение к разрабатываемой программе механизма отслеживания утечек памяти осуществляется в два этапа. Сначала в отладочной версии программы нужно выполнить подмену функций для работы с кучей их отладочными версиями. Это делается посредством следующих строк кода:
Хорошим местом для размещения этих строк является файл stdafx.h — стандартный заголовочный файл (header file) создаваемых в среде Microsoft Visual Studio проектов.
ПРИМЕЧАНИЕ
Файл stdafx.h предназначен для подключения часто используемых, но редко изменяемых в процессе разработки приложения заголовочных файлов, в частности, заголовочных файлов стандартной библиотеки C++. На основе stdafx.h строится файл предварительно скомпилированных заголовков (precompiled headers file, .pch-файл), позволяющий существенно сократить время компиляции проекта за счёт исключения необходимости повторной компиляции файлов, подключенных в stdafx.h.
ПРИМЕЧАНИЕ
Подмену оператора new приведённым выше способом нужно делать после подключения тех классов, которые переопределяют этот оператор: в частности, после подключения файлов стандартной библиотеки iostream , string , list и др.
После подмены функций работы с кучей для формирования и вывода отчёта об утечках памяти по завершении выполнения программы необходимо в начале функции main поместить код:
Здесь вызов функции _CrtSetDbgFlag также находится внутри блока условной компиляции и, следовательно, будет компилироваться только при условии, что определена символическая константа препроцессора _DEBUG , т. е. только при сборке отладочной версии программы.
Для того чтобы протестировать работу механизма отслеживания утечек памяти, подключите его к программе, рассмотренной в предыдущем разделе. Скомпилируйте отладочную версию этой программы и запустите её из среды разработки. По завершении выполнения программы посмотрите на вывод в окне Output — информации об утечках памяти быть не должно. Закомментируйте в последней строке функции main оператор удаления объекта, адресуемого p1 , снова скомпилируйте и запустите программу в режиме отладки. После завершения её работы вновь посмотрите на вывод в окне Output и сравните его с тем, что был во время предыдущего запуска программы.
Стиль определения указателей
В рассмотренных нами примерах стиль определения указателей таков: каждый указатель (равно как и любой другой объект) определяется на отдельной строке; символ ‘*’ пишется сразу (без промежуточных пробелов) за названием типа объектов, которые определяемый указатель может адресовать:
При таком подходе, int* можно трактовать как тип «указатель на int».
Если вы предпочитаете определять более одного объекта в строке, то символ ‘*’ необходимо записывать непосредственно перед определяемым указателем:
В противном случае, вид определения не будет отражать его сути. В строке
указателем является только переменная p1 ; переменные p2 и p3 — это объекты типа int . Определение трёх указателей в одной строке осуществляется так:
Брайан Керниган и Деннис Ритчи в книге «Язык программирования C» [2] отмечают, что изначально форма объявления int *p «задумывалась как мнемоническая. Объявление сообщает, что выражение *p имеет тип int . Синтаксис объявления переменной копирует синтаксис выражений, в котором эта переменная может появляться».
Резюме
Конечно же, у каждой операционной системы своя собственная архитектура памяти, имеющая несколько более сложную модель управления, чем та, что была нами рассмотрена. Однако пока вы не занимаетесь специальными вопросами программирования под конкретную операционную систему и не решаете задачи разделения данных между разными приложениями, рассмотренной модели вполне достаточно.
Что касается операционных систем семейства Microsoft Windows, то архитектура памяти, особенности управления ею, внутреннее устройство кучи и стека, файлы, проецируемые в память, и прочее исчерпывающе описаны в книге Джеффри Рихтера «Windows для профессионалов» [7].
О нетривиальных подходах к управлению памятью, написании собственных диспетчеров памяти для нестандартного размещения объектов конкретных классов, а также об умных, мудрых, гениальных, ведущих и невидимых указателях можно почитать в книге Джеффа Элджера «C++: библиотека программиста» [4], содержание которой более точно отражает английский вариант названия «C++ for Real Programmers».
Хранение данных в компьютере
Погружение в архитектуру памяти компьютера, включая ОЗУ, постоянную память, регистры, кэш, буферную память и виртуальную память. Узнайте, как они работают вместе для выполнения ваших программ.
Основы аппаратной памяти компьютера
В общем виде, компьютерная память — это набор устройств, которые сохраняют данные в виде цифровой информации. Компьютерная память может сохранять данные на разные промежутки времени: от короткого (только на время выполнения программы или даже меньше) до длительного (до тех пор, пока информацию не удалить вручную).
Разные типы памяти работают на разных скоростях, обладают разной стоимостью и эффективностью, поэтому разбор и понимание их особенностей критически важны.
Виды компьютерной памяти и их особенности
Память компьютера это гибкая и многоуровневая система. Самыми основными являются:
Оперативная память (ОЗУ) представляет собой временное хранилище для данных, которые процессор может быстро прочитать или в которые он может записать. Она динамическая, что означает, что данные в ней сохраняются только на время работы компьютера и теряются при выключении.
Постоянная память, наоборот, хранит данные независимо от состояния питания компьютера. Примеры устройств постоянной памяти включают жесткие диски (HDD), твердотельные накопители (SSD) и флеш-память.
Регистры процессора — это маленькие блоки памяти, которые находятся непосредственно в процессоре. Они обеспечивают самый быстрый доступ к данным из всех типов памяти и используются для хранения промежуточных результатов и управления выполнением инструкций процессором.
Оперативная память (ОЗУ)
Оперативная память, известная как ОЗУ (от англ. "Random Access Memory"), играет критически важную роль в функционировании компьютера. Как ключевой компонент аппаратной архитектуры, ОЗУ служит временным хранилищем данных для центрального процессора (ЦП).
В ОЗУ хранятся все данные, которые процессору могут понадобиться в ближайшее время. Это включает в себя программный код, данные приложений, информацию о состоянии системы и другое. Когда процессору требуется прочитать или записать данные, ОЗУ обеспечивает гораздо более быстрый доступ к данным, чем постоянное хранилище данных, такое как жесткий диск.
ОЗУ часто описывают как "волатильную" память, что означает, что все данные, хранящиеся в ОЗУ, теряются, когда компьютер выключается или перезагружается. Это одно из ключевых отличий ОЗУ от постоянной памяти, которую мы обсудим далее.
Одной из особенностей ОЗУ является то, что оно представляет собой «память с произвольным доступом». Это означает, что время доступа к любому месту в ОЗУ почти одинаково, независимо от физического местоположения данных в памяти. Это отличает ОЗУ от так называемой последовательной памяти, где время доступа зависит от местоположения данных.
Принцип работы ОЗУ
ОЗУ — это физическое устройство, обычно в виде модуля или нескольких модулей, установленных на материнской плате компьютера. Внутри каждого модуля находятся микросхемы, состоящие из множества транзисторов и конденсаторов. Они формируют ячейки памяти, которые хранят биты информации.
Оперативная память работает по принципу «сетки». Каждый бит информации хранится в ячейке, которая имеет свою уникальную адресацию. Вся оперативная память разбивается на ячейки равного размера, каждая из которых может хранить определенное количество байтов. Когда процессору требуется прочитать данные из ОЗУ, он отправляет на шину адресов адрес ячейки, которую он хочет прочитать, и контроллер памяти возвращает данные из этой ячейки на шину данных.
Все ячейки ОЗУ постоянно обновляются, даже если процессор не обращается к ним. Это связано с тем, что информация в ячейках хранится с помощью транзисторов и конденсаторов, которые постепенно теряют свое заряд и, следовательно, информацию. Этот процесс обновления информации называется «рефреш» и происходит автоматически. Вот почему ОЗУ называют «динамическим» — информация в нем постоянно динамически обновляется.
Однако эта особенность ОЗУ также означает, что оно требует постоянного питания для поддержания хранящейся в нем информации. Если питание пропадает, все данные в ОЗУ теряются. Именно поэтому мы говорим о том, что ОЗУ — это «волатильная» память.
Постоянная память
Постоянная память обычно служит для хранения файлов, операционных систем, приложений и других видов информации, которые необходимы компьютеру для его функционирования. Когда вы сохраняете документ, загружаете музыку или устанавливаете программу, эти данные хранятся в постоянной памяти.
В отличие от ОЗУ, постоянная память обычно работает медленнее, но обеспечивает значительно больше пространства для хранения данных. Это делает её идеальным местом для хранения всего, что необходимо сохранить между сеансами работы на компьютере.
Типы постоянной памяти: HDD, SSD, и Flash
Давайте рассмотрим три основных типа постоянной памяти: жесткие диски (HDD), твердотельные накопители (SSD) и флеш-память. Хотя эти устройства могут использовать различные технологии для хранения данных, у всех их общая особенность — сохранение данных без постоянного источника питания.
HDD (Hard Disk Drive): Жесткий диск — это классический тип постоянной памяти. Он использует магнитное покрытие для хранения данных. Данные записываются и читаются с помощью магнитной головки, которая перемещается над вращающимися дисками. HDD обычно предлагают большой объем хранения по сравнительно низкой цене, однако скорость чтения и записи обычно ниже, чем у SSD или флеш-памяти.
HDD
SSD (Solid State Drive): Твердотельные накопители не имеют движущихся частей, в отличие от HDD. Они используют флеш-память для хранения данных, что позволяет достигать гораздо более высоких скоростей чтения и записи. Однако, по сравнению с HDD, SSD обычно стоят дороже за единицу объема.
SSD
Flash-память: Флеш-память — это тип постоянной памяти, который часто используется в портативных устройствах, таких как USB-накопители, карточки памяти и смартфоны. Она использует электронные ячейки для хранения данных и может быстро читать и записывать информацию. Флеш-память обычно меньше и менее дорога, чем SSD, но может обеспечивать меньший срок службы из-за ограниченного числа циклов записи и стирания.
Все эти три типа постоянной памяти имеют свои преимущества и недостатки, и выбор между ними часто зависит от конкретных требований к хранилищу данных.
Кэш-память
Переходим к более специфическому виду памяти — кэш-памяти. Это особый тип памяти, служащий для увеличения скорости обработки данных. Следующие два раздела детально расскажут об основах кэш-памяти и о способах её работы и типах.
Основы кэш-памяти
Кэш-память — это вид компьютерной памяти, обеспечивающей высокоскоростной доступ к данным. Это небольшой объем очень быстрой памяти, расположенной непосредственно на или рядом с процессором. Она создана для хранения и быстрого доступа к часто используемым данным и инструкциям.
Кэш-память является одним из ключевых элементов, определяющих производительность системы, поскольку она уменьшает необходимость обращения процессора к относительно медленной оперативной памяти (ОЗУ). Вместо этого процессор может получить необходимые данные из кэша, что происходит значительно быстрее.
Концепция кэш-памяти основывается на принципе локальности, который гласит, что программы имеют тенденцию переиспользовать данные и инструкции, которые они недавно использовали или используют в данный момент. В связи с этим, кэширование таких данных и инструкций может значительно увеличить производительность системы.
Работа и типы кэш-памяти
Кэш-память часто организуется в несколько уровней (L1, L2, L3), каждый из которых имеет различную скорость, размер и близость к процессору. L1-кэш — это наиболее быстрый и находится ближе всего к ядрам процессора, но его размер обычно самый маленький. L2 и L3 кэши больше и медленнее, но все еще быстрее, чем ОЗУ.
Процесс заполнения и вытеснения данных в кэш-памяти определяется политикой кэширования. Одной из наиболее распространенных политик является LRU (Least Recently Used), которая вытесняет наименее недавно использованные данные при необходимости освободить место для новых данных.
Также стоит упомянуть о кэше ассоциативности. Кэш-память может быть прямого отображения (каждый блок памяти может быть сохранен только в определенном месте в кэше), полностью ассоциативной (любой блок памяти может быть сохранен в любом месте в кэше) или ассоциативной по наборам (средний вариант между первыми двумя).
Регистры процессора
Регистры — это маленькие, очень быстрые устройства хранения данных, находящиеся непосредственно в процессоре. Они используются для хранения информации, которая нуждается в быстром доступе во время выполнения инструкций. В контексте архитектуры компьютера, регистры — это наиболее быстродействующие устройства памяти.
Размер регистров обычно измеряется в битах и варьируется в зависимости от архитектуры процессора. Например, в 32-битных архитектурах используются регистры размером 32 бита, в то время как 64-битные архитектуры используют регистры размером 64 бита.
Основное назначение регистров — хранение промежуточных результатов вычислений и управление выполнением инструкций. Например, при выполнении математической операции, процессор может использовать регистры для временного хранения входных данных, промежуточных результатов и конечного результата.
Регистры играют важную роль в ускорении работы компьютера, так как доступ к регистрам обычно быстрее, чем к другим видам памяти, таким как ОЗУ или постоянная память. Однако их количество ограничено, поэтому эффективное использование регистров является важным аспектом процесса проектирования и оптимизации программного обеспечения.
struchkov.dev Struchkov Mark
Типы регистров и их роли
Процессоры используют различные типы регистров, каждый из которых выполняет свою уникальную функцию. Понимание этих функций поможет вам лучше понять, как работает процессор. Давайте рассмотрим некоторые из наиболее распространенных типов регистров:
Аккумуляторные регистры: Это регистры общего назначения, которые используются для временного хранения промежуточных результатов арифметических и логических операций. В большинстве процессоров есть несколько аккумуляторных регистров, чтобы упростить параллельное выполнение инструкций.
Регистры индексов: Они используются для изменения значений операндов в процессе выполнения программы. Они могут содержать смещение или индекс, который добавляется к адресу операнда для получения фактического адреса в памяти.
Регистры счетчиков команд: Этот тип регистра хранит адрес следующей инструкции, которую следует выполнить процессором. Когда инструкция выполнена, значение в регистре счетчика команд автоматически обновляется.
Регистры состояния/флагов: Эти регистры используются для хранения состояния процессора и информации о результате последней операции. Например, они могут указывать, было ли последнее арифметическое вычисление положительным, отрицательным или вызвало переполнение.
Регистры базового указателя стека (BP) и указателя стека (SP): Эти регистры используются для управления стеком программы. Указатель стека (SP) указывает на вершину стека, а базовый указатель стека (BP) служит точкой отсчета для доступа к переменным и аргументам функции.
Важно отметить, что точное количество и типы регистров могут значительно отличаться в зависимости от архитектуры процессора. Однако основные функции, описанные здесь, встречаются в большинстве процессоров.
Буферная память
Буферная память, или просто буфер, представляет собой область памяти, выделенную для временного хранения данных во время их передачи между двумя местами. Это особенно полезно в ситуациях, когда скорость чтения данных отличается от скорости их записи.
Наиболее ярким примером использования буферов являются аудио и видео потоковые сервисы, такие как YouTube или Netflix. Когда вы начинаете воспроизводить видео, данные начинают загружаться и храниться в буфере. Если ваше интернет-соединение достаточно быстрое, буфер заполняется быстрее, чем данные потребляются во время воспроизведения. Это позволяет вам просматривать видео без прерываний, даже если скорость интернет-соединения временно уменьшается.
В контексте компьютерной архитектуры буферы часто используются для обработки ввода/вывода. Например, когда данные передаются через USB, они первоначально хранятся в буфере, прежде чем они могут быть обработаны. Это позволяет устройствам работать с данными на своей собственной скорости, не ожидая друг друга.
Таким образом, буферная память является ключевым компонентом во многих областях информационных технологий, от потокового воспроизведения медиа до передачи данных между устройствами.
Буферная память может быть реализована в различных формах и может располагаться в разных местах, в зависимости от того, как и для чего она используется.
На уровне аппаратного обеспечения: Буферы могут быть интегрированы прямо в аппаратное обеспечение устройств. Например, в сетевых адаптерах или дисковых контроллерах есть аппаратные буферы, которые временно хранят данные, передаваемые между устройствами и компьютером.
В оперативной памяти: При работе с файлами или потоками в операционной системе данные часто временно хранятся в буфере в оперативной памяти (ОЗУ). Это позволяет оптимизировать чтение и запись данных, особенно при работе с медленными устройствами ввода/вывода.
На диске: В некоторых случаях буферы могут использоваться для временного хранения больших объемов данных на диске. Это может быть полезно для операций, которые требуют больших объемов памяти, таких как сортировка больших наборов данных или выполнение сложных запросов в базе данных.
Итак, место расположения буферной памяти в значительной степени зависит от её назначения и требований к скорости и объему хранимых данных.
Виртуальная память
ОЗУ имеет ограниченный размер, и этот размер напрямую влияет на производительность компьютера. Если процессу необходимо больше памяти, чем доступно в ОЗУ, операционная система начинает использовать диск для временного хранения данных, что существенно замедляет работу системы.
Виртуальная память — это ключевая концепция, позволяющая операционным системам и приложениям эффективно использовать физическую память компьютера. Виртуальная память создает абстракцию, которая «обманывает» приложения, заставляя их думать, что у них есть доступ к большему объему памяти ОЗУ, чем на самом деле есть в системе.
Роль виртуальной памяти
Эффективное использование памяти: Виртуальная память позволяет операционной системе эффективно распределять память между приложениями и управлять ею, когда физическая память (ОЗУ) заполняется. Приложениям предоставляются «виртуальные адреса памяти», которые затем маппятся на реальные адреса в физической памяти.
Изоляция процессов: Каждому процессу выделяется собственное виртуальное адресное пространство, что помогает предотвратить случайное повреждение данных другими процессами.
Упрощение загрузки и исполнения программ: Виртуальная память позволяет загружать программы в память по частям и выполнять их, даже если вся программа не умещается в физической памяти. Это также позволяет приложениям использовать динамическую память, которая может быть выделена и освобождена по мере необходимости.
Работа виртуальной памяти
Виртуальная память использует механизм подкачки («swapping»), который перемещает данные между быстрой физической памятью (ОЗУ) и более медленной постоянной памятью (например, жесткий диск или SSD). Когда ОЗУ заполняется, операционная система может переместить некоторые данные (или «страницы памяти») из ОЗУ на диск, освободив тем самым место для других данных.
Важно отметить, что использование виртуальной памяти, хотя и увеличивает общий доступный объем памяти, но может привести к снижению производительности, особенно если системе приходится часто производить страничный обмен из-за недостатка ОЗУ.
BIOS и флэш-ПЗУ
BIOS (Basic Input/Output System) и ПЗУ (Постоянное Запоминающее Устройство), специфически флеш-ПЗУ, играют важную роль в загрузке и функционировании компьютерной системы. Посмотрим на каждый из этих компонентов подробнее.
BIOS – это набор программ, хранящихся на микросхеме ПЗУ материнской платы. Это первая программа, которую запускает компьютер при включении. BIOS отвечает за инициализацию и тестирование аппаратного обеспечения системы, а затем передает управление операционной системе.
При старте системы, BIOS выполняет следующие основные функции:
POST (Power-On Self Test): Это серия диагностических тестов, которые проводятся для проверки основного оборудования, такого как процессор, память и видеоадаптер.
Bootstrap Loader: BIOS обнаруживает, загружает и передает управление операционной системе, находящейся на загрузочном устройстве (чаще всего это жесткий диск или SSD).
BIOS Setup: BIOS предоставляет меню настройки, в котором можно изменить параметры системы, такие как порядок загрузки, настройки разгона, настройки энергосбережения и другие.
Флеш-ПЗУ
Флеш-ПЗУ – это вид постоянной памяти, который можно переписывать и стирать. В отличие от традиционного ПЗУ, данные в флеш-ПЗУ можно обновить без замены всей микросхемы.
В контексте загрузки системы, BIOS обычно хранится на флеш-ПЗУ, что позволяет легко обновлять программное обеспечение BIOS. Такие обновления могут включать исправления ошибок, улучшения совместимости и новые функции.
Таким образом, BIOS и флеш-ПЗУ вместе обеспечивают критически важный процесс инициализации и загрузки операционной системы на компьютере.
Заключение
Процесс управления памятью — это ключевой компонент, который определяет производительность и эффективность компьютерных систем и программного обеспечения. Как мы увидели, это касается как аппаратной, так и программной составляющих компьютера.
Оперативная память (ОЗУ) и постоянная память обладают уникальными свойствами и выполняют различные функции в компьютере. В то время как ОЗУ служит для временного хранения данных и быстрого доступа, постоянная память сохраняет данные даже при отключении питания. При разработке ПО понимание этих различий помогает создавать эффективные и производительные приложения.
Кроме того, регистры процессора играют важную роль в обработке данных и выполнении операций. Они обеспечивают быстрый доступ к данным, который является критическим для высокоскоростных вычислений.
Адресное пространство процесса в Windows
Оперативная память (ОЗУ) является тем компонентом персональных компьютеров, важность которого, при современной архитектуре вычислительных систем, сложно переоценить, и без которого работа их (в силу архитектурных особенностей) не представляется возможной. Было бы интересно посмотреть, как именно ОС управляет доступной ей памятью? Как она распределяет её между загруженными приложениями? Как происходит организация (создание) в памяти нового процесса, как код программы получает управление и как процессу выделяется дополнительная память по запросу, в случае, когда выделенная изначально память заканчивается? Как организовано адресное пространство процесса? Подобные вопросы возникали и продолжают возникать у многих довольно часто, но далеко не на все из них находятся вразумительные ответы. Поскольку круг вопросов, касающихся оперативной памяти настолько велик, что не может быть освещен в одной статье, здесь мы коснемся лишь части огромного механизма управления памяти в ОС Microsoft Windows, а именно изучим адресное пространство процесса, увидим, что же размещается [системой] в пространстве памяти, выделяемой процессу.
Код приложений (программ), исполняемый в произвольный момент времени на процессоре, оперирует данными. Данные, которые в текущий момент необходимы коду для выполнения, должны быть размещены в физической (оперативной) памяти или регистрах общего назначения. Если данные размещены в памяти, то их положение нужно каким-либо образом определить — проще всего сделать это при помощи некоего числа (порядкового номера), называемым адресом [в массиве]. Иными словами, оперативную память легче всего себе представить в виде массива байт. Чтобы обратиться к конкретному байту данных (массива), или адресовать его , логично было бы использовать порядковый номер. Подобным образом можно поступить со всеми байтами, пронумеровав их целыми положительными числами, установив ноль за начало отсчёта. Индекс байта в этом огромном массиве и будет его адресом.
Адресация на уровне процессора
В первых микропроцессорах компании Intel (архитектуры x86 ) был доступен единственный режим работы процессора, впоследствии названный реальным режимом . Адресация памяти в процессорах того времени была достаточно простой и носила название сегментной . Суть её заключалась в том, что ячейка памяти адресовалась при помощи двух составляющих: сегмент : смещение (сегмент — область адресного пространства фиксированного размера, смещение — адрес ячейки памяти относительно начала сегмента). Специфика архитектуры упомянутых [первых] микропроцессоров накладывала ограничения на размер физического адресного пространства (16 килобайт, 64 килобайта, 1 мегабайт. ), и память, доступная программно, была не более размера оперативной (физически установленной) памяти компьютера. Это было просто, логично и понятно. Тем не менее, описанная архитектура имела ряд недостатков, к тому же в индустрии появились тенденции дальнейшего развития:
Была актуальна проблема согласования выделения памяти различным приложениям. Размещение кода/данных приложений в едином для всех программ пространстве памяти требовало от операционной системы (а иногда и от самой программы) сложного механизма постоянного отслеживания занятого пространства.
Наметился переход к многозадачным операционным системам, в которых большое количество задач должно было выполняться [псевдо]параллельно, что затрудняло использование общего пространства памяти.
В условиях множества одновременно выполняющихся задач встала проблема безопасности, необходимости ограничения доступа к «чужим» процессам в памяти.
Эти, а так же некоторые другие, проблемы явились отправной точкой для работы над усовершенствованием, в следствии чего в процессоре 80286 появился защищенный режим и концепция сегментной адресации памяти была значительно расширена для обеспечения новых требований. Например в защищенном режиме сегменты могли располагаться (начинаться) в памяти в произвольном месте (база), иметь нефиксированный размер (лимит), уровни доступа, типы содержимого и прочее. И наконец, по прошествии некоторого времени была создана новая архитектура, получившая название IA-32 , в которой были введены несколько новых моделей организации оперативной памяти:
Базовая плоская модель (basic flat model) — наиболее простая модель памяти [системы], операционная система и приложения получают в своё распоряжение непрерывное, не сегментированное адресное пространство.
Защищенная плоская модель (protected flat model) — более сложная модель памяти [системы], может применяться страничный механизм изоляции пользовательского/системного кода/данных, описываются четыре сегмента: кода/данных (для уровня привилегий 3, пользовательский уровень) и кода/данных (для уровня привелегий 0, ядро).
Мульти-сегментная модель (multi-segment Model) — самая сложная модель памяти [системы], предоставляется аппаратная защита кода, данных, программ и задач. Каждой программе (или задаче) назначаются их собственные таблицы [сегментных] дескрипторов и собственные сегменты.
Страничная организация памяти это альтернативный тип управления памятью, разработанный для обеспечения организации виртуального адресного пространства (виртуальной памяти) в многозадачных операционных системах. В отличие от сегментной адресации, которая делила адресное пространство на сегменты определенной длины, страничная адресация делит пространство на множество страниц равного размера. Изменения коснулись и принципов адресации: если в реальном режиме работы процессора пара сегментный_регистр : смещение могла адресовать ячейку памяти, то в защищенном режиме сегмент был заменен на селектор, который содержал индекс в таблице дескрипторов и биты вида таблицы дескрипторов + биты привилегий.
Механизм трансляции адресов (преобразование адреса)
Поскольку одним из нововведений защищенного режима было создание виртуальной адресации, потребовались механизм трансляции виртуальных адресов в физические, а так же механизм трансляции страниц. Именно благодаря трансляции операционная система имеет возможность создавать для каждого процесса иллюзию полноразмерного обособленного адресного пространства и обеспечивать защиту собственного ядра [от пользовательских процессов]. Адрес, по которому код программы (процесса) пытается обратиться к данным (где-то в оперативной памяти), изначально закодирован в исполняемой инструкции (пример фрагмента кода):
..и проходит через некоторое количество преобразований, начиная от декодирования инструкции процессором и заканчивая выставлением адреса на шину. Давайте посмотрим, какие же этапы проходит преобразование адреса:
Эффективный адрес — адрес, задаваемый в аргументах машинной инструкции при помощи регистров, смещений, коэффициентов. Фактически эффективный адрес представляет собой смещение от начала сегмента (базы). Как раз для нашего примера (выше): эффективный адрес = EDI + ECX * 4 + 4 ;
Логический адрес – адрес, представляющий собой пару селектор : смещение . Традиционно селектор (левая часть) располагается в сегментном регистре, смещение (правая часть) в регистре общего назначения или указывается непосредственно, для нашего примера это: DS : [EDI+ECX*4+4] . Как мы видим, часто сегментный регистр (левая часть) не указывается (выбирается неявно). Фактически с логическими адресами и имеет дело программист в своих программах;
Линейный адрес — это 32-/64-разрядный адрес, получаемый путем использования селектора (содержащегося в левой части виртуального адреса, в сегментном регистре, для нашего примера задан неявно, в DS ) в качестве индекса в таблице дескрипторов (для вычисления базы сегмента) и добавления к ней смещения (правая часть виртуального адреса, в нашем случае значение, вычисляемое на основе выражения EDI+ECX*4+4 ). Линейный адрес = база сегмента + эффективный адрес .
Гостевой физический адрес — при использовании аппаратной виртуализации. В случае, когда в системе работают виртуальные машины, физические адреса (получаемые в каждой из них), необходимо транслировать ещё раз.
Физический адрес — это финальная часть преобразований адреса внутри процессора. Физический адрес:
(для сегментной адресации) полностью совпадает с линейным адресом;
(для сегментно-страничной адресации) получается путем преобразования трех частей значения линейного адреса на основании: каталога страниц, таблицы страниц и смещения внутри страницы;
Отсюда следует, что существуют логическое , линейное и физическое адресные пространства, которые активно взаимодействуют между собой, и на совокупности которых основана адресация в современных операционных системах. Фактически, процесс преобразования адресов, используемых программистом в своей программе в адрес физической ячейки оперативной памяти, является цепочкой преобразований от первого пункта к последнему и именуется трансляцией адресов (прозрачное преобразование одного вида адреса в другой).
Механизм трансляции страниц (страничное преобразование)
Алгоритмы преобразования линейного адреса в физический (этапы 3 → 5) варьируются в зависимости от множества причин (состояния определенных регистров). В некоторых режимах линейный адрес делится на несколько частей, при этом каждая часть является индексом в специализированной системной таблице (все они расположены в памяти), а число и размер описанных таблиц различаются в зависимости от режима работы процессора. Запись в таблице первого уровня представляет собой адрес начала таблицы следующего уровня, а для последнего уровня — информация о физическом адресе страницы в памяти и её свойствах. Иначе говоря:
Соответственно, на данном этапе, мы уже имеем дело уже с разбиением адресного пространства на страницы (определенного размера) или со страничной организацией памяти. Иными словами, мы имеем дело с виртуальной памятью. Процессор как бы делит линейное адресное пространство на блоки (страницы) фиксированного размера (в зависимости от установок — 4Кб, 2Мб, 4Мб), которые уже могут отображаются в физической памяти или на жестком диске. И вот тут стоит обратить внимание на один крайне важный аппаратный механизм:
Иными словами, преобразование линейного адреса в физический может закончиться неудачей, если:
страницы в данный момент нет в физической памяти;
таблицы не содержат необходимых данных;
недостаточно прав доступа;
Во всех этих случаях возникает аппаратное событие — так называемое исключение Page Fault (#PF), которое предписывает обработчику исключения произвести дополнительные действия по устранению возникшей проблемы: подгрузить (отсутствующую) страницу с диска (либо скинуть (ненужную) страницу на диск). Как только страница была подгружена, то выполнение прерванного кода продолжится с инструкции, которая вызвала #PF. Именно механизм страничной адресации (преобразования) и позволяет операционной системе организовать виртуальное адресное пространство, о котором речь пойдет далее. К сожалению, подробное описание механизмов преобразования адресов и типов адресации выходит за рамки данной статьи, далее мы переходим к «программному» уровню, то есть непосредственно к механизмам операционной системы.
Адресация на уровне ОС
Сами понимаете, что было бы не совсем корректно называть излагаемое в данной главе некоей «программной» частью адресации в операционной системе, поскольку:
..поэтому операционная система Windows эксплуатирует особенности той архитектуры, на которой она в данный момент функционирует (выполняется) и всего-лишь использует аппаратные механизмы [процессора]. Становится очевидным, что если Windows исполняется на станциях, построенных на базе процессоров архитектуры IA-32 , то используется защищенный режим работы процессора. Версии операционной системы Windows для архитектуры IA-32 , пользуются механизмом сегментации защищенного режима лишь в минимальном объёме:
используются всего два уровня привилегий: 0 и 3;
и из всех доступных способов организации памяти используется защищенная плоская модель со страничной адресацией (protected flat model);
Есть соглашение, что все селекторы для процесса идентичны, это значит что адресация внутри процесса фактически базируется на смещении (а селекторы сегментов остаются неизменными). Исходя из этого, если каждый процесс [в системе] использует собственное адресное пространство линейным способом, то есть адресация базируется (фактически) на смещении, селекторы сегментов остаются неизменными, то сегментные регистры не нужны и их можно «опустить», «упразднить». На основе плоской модели памяти базируется часто упоминаемый в литературе механизм виртуальной памяти.
Возникает вопрос: почему это пространство называется виртуальным? А потому что виртуальный адрес может и не присутствовать в физической памяти , все механизмы [защищенного режима] созданы лишь для имитации (создания иллюзии для программы) его существования, ведь используются селекторы : смещения (которые могут ссылаться на любой адрес) совместно со страничным преобразованием (страницы могут быть сопоставлены с физической памятью, а могут и не быть), то есть все сущности по сути эфемерны, пользователь не знает как и где они размещены!!
Размерность адресных пространств
Не случайно во множественном числе, поскольку и эта тема несет в себе огромное количество неопределенностей и неточностей. Выше мы говорили о том, что существуют логическое , линейное и физическое адресные пространства в архитектуре процессора.
Физическое адресное пространство
Итак, размерность физического (процессорного) адресного пространства зависит от особенностей аппаратной архитектуры:
32-бита : используются 32-битные указатели (размерность 4 байта), и размер адресного пространства равен 2 32 = 4294967296 байт (4 гигабайта, Гб). Шестнадцатеричное представление диапазона: 00000000 — FFFFFFFF .
64-бита : используются 64-битные указатели (размерность 8 байт) и размер адресного пространства процесса равен 2 64 = 18446744073709551616 байт (16 экзабайт, Эб.
Разрядность (битность) приложения
Разрядность указателя
Размер адресного пространства [процесса]
Адреса диапазона (шестнадцатеричные)
32 бита
32 бита (4 байта)
2 32 (4294967296 байт = 4 гигабайта)
00000000 — FFFFFFFF
64 бита
64 бита (8 байт)
2 64 (18446744073709551616 байт =
Но это, опять же, теоретическая адресация на основе разрядности.
Линейное адресное пространство
Линейное адресное пространство процесса теоретически могло бы быть идентично физическому адресному пространству, но на практике вступают в действие ограничения операционной системы , которые зависят от: версии операционной системы, [определенных] настроек (флагов) операционной системы и приложений, типа запуска: 32-битное приложение на 32-битной ОС, 32-битное приложение на 64-битной ОС, 64-битное на 64-битной ОС.
32-бита : размер линейного адресного пространства процесса равен 4Гб, верхние 2Гб (или 1Гб, в зависимости от флагов) из которых защищены на уровне страниц. Поэтому для пользовательского приложения в 32-битной ОС определен лимит в 2Гб (или 3, в зависимости от флагов), за пределы которого процесс выбраться не может (без использования специализированных технологий вида AWE).
64-бита : размер линейного адресного пространства процесса равен 16Тб или 256Тб, из которых (верхняя) часть защищена на уровне страниц. Поэтому 32/64-битному пользовательским приложениям может быть определен лимит в 2Гб, 4Гб, 8Тб и 128Тб (в зависимости от разрядности/версии/флагов).
Виртуальные адреса используются приложениями, однако сама операционная система (равно как и процессор) не способна по этим виртуальным адресам непосредственно обращаться к данным, потому как виртуальные адреса не являются адресами физического устройства хранения информации (ОЗУ/ДИСК), другими словами физически по этим адресам информация не хранится.
Или, если выразиться иначе, выполняемый код или используемые данные должны находиться в физической памяти, только в этом случае они будут выполнены/обработаны процессором.
Использование страничной организации операционной системой
Получается интересная ситуация: с одной стороны, для каждого процесса в операционной системе Windows выделяется адресное пространство, которое фактически эквивалентно размерности теоретического адресного пространства; с другой стороны размер физически установленной оперативной памяти (ОЗУ) компьютера может быть в разы меньше суммы всех адресных пространств процессов, исполняемых в данный момент в системе. Как нам в подобной ситуации обеспечить нормальное функционирование операционной системы? А очень просто, поскольку:
виртуальные адреса суть иллюзия, они могут не ссылаться на физическую память;
[в подавляющем большинстве случаев] процесс не использует всё виртуальное адресное пространство, отведенное для него; то есть адресное пространство процесса не обязательно заполнено [под завязку] данными;
общие для всех процессов данные могут разделяться множеством процессов (экономия оперативной памяти);
не обязательно код и данные всех процессов [постоянно] держать в ОЗУ (экономия оперативной памяти);
И в обеспечении всех этих механизмов нам на помощь приходит страничная организация (о которой говорилось выше): она позволяет операционной системе прозрачно (незаметно) для пользователя/приложения выполнять ряд очень нужных системе манипуляций:
подгружать/выгружать неиспользуемые страницы с/на носитель информации (жесткий диск: HDD, SSD);
проецировать общие страницы [общих ключевых библиотек] в несколько адресных пространств одновременно;
Страницы, которые в определенный промежуток времени не используются, из ОЗУ переносятся (перепроецируются) на любой физический носитель, установленный в системе — в файл (файл подкачки, страничный файл, page file, swap-файл, «своп») либо [в некоторых ОС] в область подкачки (специализированный раздел). Сопоставлением (отображением) виртуальных адресов на физические адреса ОЗУ или файла подкачки занимается так называемый диспетчер виртуальной памяти (VMM, Virtual Memory Manager).
Упрощенная схема процесса «отображения» выглядит следующим образом:
Схема действительно упрощена, поскольку на деле в процессе сопоставления участвует множество структур: таблица указателей на каталог страниц, каталог страниц, таблица страниц. Как видно из нашего рисунка, виртуальные адреса могут проецироваться на физическую намять, файл подкачки или любой файл, располагающийся в файловой системе. На основе приведенной схемы мы может сделать довольно-таки важный вывод:
и теперь вы, надеюсь, понимаете, что:
Получается, что у виртуальных страниц адреса одни, аппаратные страницы выделяются по мере необходимости из имеющихся в наличии свободных страниц физической памяти, и, понятное дело, что физические адреса будут случайными и, в большинстве случаев, не будут совпадать с виртуальными. Напомню, что синхронизация между виртуальными и физическими страницами памяти обеспечивается аппаратно (на уровне процессора), называется страничным преобразованием и была нами описана выше. Наиболее значимые особенности виртуальной памяти таковы:
Виртуальная память, доступная программе, напрямую не связана с физической памятью.
Каждая программа работает в своей виртуальном адресном пространстве. Размер этого пространства может быть больше размера фактически установленной в машине оперативной памяти.
Адресное пространство [каждого] процесса (программы), исполняющегося в ОС, изолировано [от подобных адресных пространств других процессов].
Когда какая-либо программа обращается к своим данным, которые [в этот момент] отсутствуют в ОЗУ, то функция обработчика страничного нарушения диспетчера виртуальной памяти производит следующие манипуляции:
сохраняет в стек адрес инструкции, следующей за инструкцией, вызвавшей #PF;
производит поиск свободной (незанятой) физической страницы;
создает новый элемент в таблице страниц;
подгружает недостающие данные из файла подкачки в ОЗУ;
производит проецирование виртуальной страницы на физическую;
производит восстановление адреса из стека и выполняет «перезапуск» инструкции (следующей за той, на которой было прервано выполнение);
Все эти процессы происходят на уровне ядра операционной системы, поэтому они «прозрачны» или «неразличимы» для пользовательского приложения (а программисту, в реалиях высокоуровневого программирования, зачастую и вовсе не интересны). Теперь несколько слов об изоляции или закрытости [адресного пространства] процесса. Виртуальное пространство [каждого] процесса изолировано, или, можно сказать по-другому — процессы отделены друг от друга в своем собственном виртуальном адресном пространстве. Поэтому любой поток в рамках некоего процесса получает доступ только лишь к той памяти, которая принадлежит родительскому процессу. Наглядно, изолированность выражается в том, что некая программа A в своем адресном пространстве может хранить запись данных по условному адресу 12345678h , и в то же время у программы B по абсолютно тому же адресу 12345678h (но уже в его собственном адресном пространстве) могут находиться совершенно другие данные. Изолированность, к тому же подразумевает, что код одной программы (если быть точным, то потока в рамках процесса) не может получить доступ к памяти другой программы (без дополнительных манипуляций). Достоинства виртуальной памяти:
Упрощается программирование. Программисту больше не нужно учитывать ограниченность памяти, или согласовывать использование памяти с другими приложениями.
Повышается безопасность. Адресное пространство процесса изолировано.
Однородность массива. Адресное пространство линейно.
[пример] Виртуальное адресное пространство процесса
Я думаю, после некоторого количества теоретических выкладок, самое время перейти ближе к рассмотрению основной темы статьи. Напомню, что мы будем исследовать структуру памяти 32-битного процесса Windows. Для исследования памяти процесса нам потребуется специализированное программное средство, которое поможет нам увидеть адресное пространство процесса в деталях. Использовать мы будем утилиту VMMap от Марка Руссиновича, отличное приложение, которое выводит подробную информацию по использованию памяти в рамках того или иного процесса. Однако, не обошлось, что называется, и без ложки дегтя. Бытует мнение, что данное ПО отражает карту процесса не достаточно подробно, игнорируя кое-какие структуры памяти, однако, как отправная точка для понимания принципов размещения объектов в памяти вполне нас устроит. Для практического эксперимента я буду использовать самописный модуль test2.exe , написанный на ассемблере, код которого предельно прост, отображает всего-лишь некоторые оконные элементы и выводит информационное окно перед выходом. В модуле используются (импортируются) функции SetFocus , SendMessageA , MessageBoxA , CreateWindowExA , DefWindowProcA , DispatchMessageA , ExitProcess , GetMessageA , GetModuleHandleA , LoadCursorA , LoadIconA , PostQuitMessage , RegisterClassA , ShowWindow , TranslateMessage , UpdateWindow из библиотек user32.dll и kernel32.dll . Итак, запускаем на исполнение тестовый файл test2.exe а затем, пока приложение исполняется, загружаем программу VMMap , указывая ей открыть наш целевой процесс. Вот что мы наблюдаем:
Поскольку информации довольно много, к карте процесса потребуется небольшое пояснение. И хотя это и не статья, описывающая функционал утилиты VMMap , однако мы должны осветить некоторые ключевые моменты, потому как без знаний о заголовках столбцов и видах типов регионов мы в изучении далеко не продвинемся.
Наименование столбца
Описание
Address
Стартовый адрес региона в виртуальном пространстве процесса. Шестнадцатеричное представление.
Type
Тип региона (см. таблицу далее).
Size
Полный размер выделенной области. Отражает максимальный размер физической памяти, которая необходима для хранения региона. Так же включает зарезервированные области.
Committed
Количество памяти региона, которое «отдано», «передано» или «зафиксировано» — то есть эта память уже связана с ОЗУ, страничным файлом [подкачки], или с отображенным файлом (mapped file) [на диске].
Private
Часть всей памяти, выделенной для региона, которая приватна, то есть принадлежит исключительно процессу-владельцу и не может быть разделена с другими процессами.
Total WS
Общее количество физической памяти, выделенной для региона (ОЗУ + файл подкачки).
Private WS
Приватная часть физической памяти [региона/файла]. Принадлежит исключительно владельцу и не может быть разделена (использована совместно) с другими процессами.
Shareable WS
Общедоступная часть физической памяти [региона/файла]. Может быть использована совместно другими процессами, которым так же необходим данный регион (файл).
Shared WS
Общедоступная часть физической памяти [региона/файла]. Уже используется совместно с другими процессами.
Locked WS
Часть физической памяти [региона/файла], которая гарантированно находится в ОЗУ и не вызывает ошибок страниц (необходимость подгрузки из файла подкачки), когда к ней пытаются получить доступ.
Blocks
Количество выделенных в регионе блоков памяти. Блок — неразрывная группа страниц с идентичными атрибутами защиты, сопоставленная с одним регионом физической памяти. Если Вы посмотрите внимательно то заметите, что значения параметра «Blocks», отличные от нуля, встречаются в регионах, которые разбиты на несколько частей (подрегионы, блоки). Обычно имеется несколько подрегионов: основной регион + резервные.
Protection
Типы операций, которые могут быть применены к региону. Для регионов, которые подразделяются на подблоки (+), колонка указывает общую (сводную) информацию по типам защиты в подблоках. В случае применения к региону неразрешенного типа операций, возникает «Ошибка доступа». Ошибка доступа происходит в случаях: когда происходит попытка запустить код из региона, который не помечен как исполняемый (если DEP включена), или при попытке записи в регион, который не помечен как предназначенный для записи или для «копирования-при-записи» (copy-on-write), или в случае попытки доступа к региону, который маркирован как «нет доступа» или просто зарезервирован, но не подтвержден. Атрибуты защиты присваиваются регионам виртуальной памяти на основе атрибутов сопоставленных регионов физической памяти.
Details
Дополнительная информация по региону. Тут могут отображаться: путь файла бэкапа, идентификатор кучи (для региона heap), идентификатор потока (для стека), указатель на .NET-домен и прочее.
Ну и необходимо описать все виды типов (type) регионов. Типы регионов у можно наблюдать на карте процесса в столбце Type :
Тип региона
Описание
Free
Диапазон виртуальных адресов не сопоставленных с физической памятью. Это память, которая еще не занята. Регион или часть региона доступны для резервирования (выделения).
Shareable
Регион, который может быть разделен с другими процессами и забекаплен в физической памяти либо файле подкачки. Подобные регионы обычно содержат данные, которые разделены между процессами, то есть используются несколькими программами, через общие, специально оформленные, секции DLL или другие объекты.
Private Data
Частные данные. Это регион, выделенный через функцию VirtualAlloc . Эта часть памяти не управляется менеджером кучи (Heap Manager), функциями .NET и не выделяется стеку. Обычно содержит данные приложения, которые используются только нашей программой и не доступны другим процессам. Так же содержит локальные структуры процесса/потока, такие как PEB или TEB . Типичная «память программы». Регион сопоставлен со страничным файлом.
Unusable
Виртуальная память, которая не может быть использована из-за фрагментации. Это осколки, которые уже закреплены за регионом. Гранулярность выделения памяти в Windows — регионы по 64Кб. Когда Вы пытаетесь выделить память с помощью функции VirtualAlloc и запрашиваете, к примеру 8 килобайт, VirtualAlloc возвращает адрес региона в 64 килобайта. Оставшиеся 56Кб помечаются как неиспользуемые (unusable). Обратите внимание на то, что области Unusable «следуют» в карте за не кратными 64Кб регионами, на самом же деле, это всего-лишь память, которая входит в регион (принадлежит региону-владельцу), но на данный момент не используется.
Image
Регион сопоставлен с образом исполняемого EXE- или DLL-файла, проецируемого в память. Это именно тот регион, куда загружается образ пользовательского приложения со всеми его секциями (в нашем случае test2.exe ).
Image (ASLR)
Образы системных библиотек, загружаемые с использованием механизма безопасности ОС под названием ASLR (Address Space Layout Randomization). ASLR — рандомизация расположения в адресном пространстве процесса таких структур как: образ исполняемого файла, подгружаемая библиотека, куча и стек. Вкратце, ОС игнорирует предпочитаемый базовый адрес загрузки, который задан в заголовке PE и загружает библиотеку в адрес по выбору «менеджера загрузки». Для поддержки ASLR, библиотека должна быть скомпилирована со специализированной опцией, либо без неё, когда используется принудительная рандомизация (ForceASLR). Таким образом, усиливается безопасность процесса и исключаются конфликты базовых адресов образов [подгружаемых модулей]. Применяется начиная с Windows Vista. Технология так же известна под псевдонимом Rebasing.
Thread Stack
Стек. Регион сопоставлен со стеком потока. Каждый поток имеет свой собственный стек, соответственно под каждый поток выделяется регион для хранения его собственного стека. Когда в процессе создается новый поток, система резервирует регион адресного пространства для стека потока. Для чего обычно используется стек? Ну как и все стеки, стек потока предназначается для хранения локальных переменных, содержимого регистров и адресов возврата из функций.
Mapped File
Проецируемые файлы. Это немного не то же, что «проецирование» образа самой программы и необходимых библиотек. Все отображаемые в адресное пространство процесса файлы могут быть трех видов: самой программой, библиотеками, и рабочими объектами. Проецируемые (mapped) файлы это и есть вот эти самые рабочие объекты, которые может создавать и использовать код программы. Обычно это файлы, которые содержат какие-либо требующиеся приложению данные и с которыми приложение работает напрямую. Проецирование файлов — наиболее удобный способ обработки внешних данных, поскольку данные из файла становятся доступны непосредственно в адресном пространстве процесса (регион памяти сопоставлен с файлом или частью файла), а на самом деле они размещаются на диске. Таким образом программе файл доступен в виде большого массива, нет необходимости писать собственный код загрузки файла в память, на лицо экономия на операциях ввода-вывода и операциях с блоками памяти. ОС делает всё это прозрачно для разработчика, собственными механизмами, получается для кода область проецируемых файлов — это обычная память. Проецируемые файлы предназначены для операций с файлами из кода основной программы, ведь рано или поздно подобные операции с файлами приходится использовать практически во всех проектах, и зачастую это влечет за собой большое количество дополнительной работы, поскольку пользовательское приложение должно уметь работать с файлами: открывать, считывать и закрывать файлы, переписывать фрагменты файла в буфер и оттуда в другую область файла. В Windows все подобные проблемы решаются как раз при помощи проецируемых в память файлов (memory-mapped files). Проецируемый в память файл может иметь имя и быть разделяемым, то есть совместно использоваться несколькими приложениями. Работа с проецируемыми файлами в пользовательском режиме обеспечивается функциями CreateFileMapping и MapViewOfFile .
Heap (Private Data)
Куча. Это регион зарезервированного адресного пространства процесса, предназначенный для динамического распределения небольших областей памяти. Представляет из себя закрытую область памяти, которая управляется так называемым «Менеджером кучи» (Heap Manager). Данные в этой области хранятся «в куче» (или «свалены в кучу»), то есть друг за другом, разнородные, без какой-либо систематизации. Смысл кучи сводится к обработке множества запросов на создание/уничтожение множества мелких объектов (блоков памяти). Куча используется различными функциями WinAPI, вызываемыми кодом Вашего приложения, либо функциями самого приложения, для выделения различных временных буферов хранения строк, переменных, структур, объектов. Память в куче выделяется участками (индексами), которые имеют фиксированный размер (8 байт).
Как Вы видите из карты процесса, всё адресное пространство процесса разбито на множество неких зон различного назначения, называемых регионами. Регионов в адресном пространстве достаточно много. Однако, для начала, давайте посмотрим на «общее» разбиение адресного пространства процесса, дабы возникло понимание, как что и где может размещаться. Разбиение адресного пространства в определенной степени зависит от версии ядра Windows. Общая концепция разбиения виртуального адресного пространства 32-битных программ:
Начало
Конец
Размер
Описание
00000000
0000FFFF
64Кб
Область нулевых указателей . Зарезервировано. Данная область всегда маркируется как свободная (Free). Попытка доступа к памяти по этим адресам вызывает генерацию исключения нарушения доступа STATUS_ACCESS_VIOLATION . Область применяется для выявления программистами некорректных, нулевых указателей, тем самым позволяя выявлять некорректно работающий код. Если по каким-то причинам (напр.: возврат значения функцией) переменная или регистр вдруг принимает нулевое (неинициализированное) значение, то дальнейшая попытка обращения к памяти (запись/чтение) с использованием данной переменной/регистра приведет к генерации исключения (напр.: mov eax, dword ptr [esi], где ESI =0).
00010000
7FFEFFFF
2Гб (3Гб)
Пользовательский режим (User mode). Пользовательская часть кода и данных. В это пространство загружается пользовательское приложение, с разбивкой по секциям. Отображаются все проецируемые в память файлы, доступные данному процессу. В этом пространстве создаются пользовательская часть стеков потоков приложения. Тут присутствуют основные системные библиотеки ntdll.dll , kernel32.dll , user32.dll , gdi32.dll .
7FFF0000
7FFFFFFF
64Кб
Область некорректных указателей . Зарезервировано. Данная область всегда маркируется как свободная (Free). Попытка доступа к памяти по этим адресам вызывает генерацию исключения нарушения доступа STATUS_ACCESS_VIOLATION . Хотя эта область формально и относится к области памяти пользовательского режима, она является «пограничной», то есть имеется риск при операциях с большими блоками памяти выйти за границы пользовательского режима и перезаписать данные режима ядра, поэтому Microsoft предпочла заблокировать доступ к данной области. Область применяется для выявления некорректных (вышедших за пределы пользовательской памяти) указателей (переменные/регистры) в коде (например: mov eax, dword ptr [esi], где ESI =значение, входящее в диапазон 7FFF0000-7FFFFFFF).
80000000
FFFFFFFF
2Гб (1Гб)
Режим ядра (Kernel mode). Код и данные модулей ядра, код драйверов устройств, код низкоуровневого управления потоками, памятью, файловой системой, сетевой подсистемой. Размещается кеш буферов ввода/вывода, области памяти, не сбрасываемые в файл подкачки. Таблицы, используемые для контроля страниц памяти процесса (PTE?). В этом пространстве создаются ядерная часть стеков для каждого потока в каждом процессе. Пространство недоступно из пользовательского режима, и попытка обращения из кода режима пользователя приведет к исключению нарушения доступа. Пространство «общее», то есть идентично (одинаково) для всех процессов системы.
Ну, регионы мы бегло рассмотрели, давайте разберемся, как же происходит построение адресного пространства для конкретного процесса? Ведь должен существовать в системе механизм выделения и заполнения регионов. Все начинается с того, что пользователь либо некий код инициируют выполнение исполняемого модуля (программы). Одни из примеров подобного действия может быть двойной щелчок в проводнике по имени исполняемого файла. В этом случае код инициирующего выполнение потока вызывает функцию CreateProcess либо родственную из набора функций, предназначающихся для создания нового процесса. Какие же действия выполняет ядро после вызова данной функции:
Находит исполняемый файл (.exe), указанный в параметре функции CreateProcess . В случае каких проблем просто возвращает управление со статусом false.
Создает новый объект ядра «процесс».
Создает адресное пространство процесса.
Во вновь созданном адресном пространстве резервирует регион (набор страниц). Размер региона выбирается с расчетом, чтобы в него мог уместиться исполняемый .exe-файл. Загрузчик образа смотрит на параметр заголовка .exe-файла, который указывает желательное расположение (адрес) этого региона. По-умолчанию = 00400000 , однако может быть изменен при компиляции.
Отмечает, что физическая память, связанная с зарезервированным регионом это сам .exe-файл на диске.
После окончания процесс проекции .exe-файла на адресное пространство процесса, система анализирует секцию import directory table , в которой представлен список DLL-библиотек (которые содержат функции необходимые коду исполняемого файла) и список самих функций.
Для каждой найденной DLL-библиотеки производится «отображение», то есть вызывается функция LoadLibrary , которая выполняет следующие действия:
Резервирует регион в адресном пространстве процесса. Размер выбирается таковым, чтобы в регион мог поместиться загружаемый DLL-файл. Желаемый адрес загрузки DLL указывается в заголовке. Если размер региона по желаемому адрес меньше размера загружаемого DLL, либо регион занят, ядро пытается найти другой регион.
Отмечает, что физическая память, связанная с зарезервированным регионом это DLL-файл на диске.
Производится настройка образа библиотеки, сопоставление функций. Результатом этого является заполненная таблица (массив) адресов импортируемых функций, чтобы в процессе работы код обращается к своему массиву для определения точки входа в необходимую функцию.
Очевидно, что в момент создания процесса, адресное пространство практически все свободно (незарезервировано). Поэтому, для того, что бы воспользоваться какой-либо частью адресного пространства, надо эту самую часть для начала выделить (зарезервировать) посредством специализированных функций.
Резервирование региона происходит вместе с выравниванием начала региона с учетом так называемой гранулярности (зависит от процессора, 64Кб). При резервировании обеспечивается дополнительно еще и кратность размера региона размеру страницы (зависит от процессора, 4Кб), поэтому если вы пытаетесь зарезервировать регион некратной величины, система округлит значение до ближайшей большей кратной величины.
Размещение в адресном пространстве структур и библиотек
Далее по тексту я буду приводить описание непосредственно регионов памяти, делая цветовую маркировку для удобства сопоставления типа региона фактически размещаемым данным.
Адрес
Модуль
Описание
00040000
apisetschema.dll
Предназначена для организации и разделения на уровни выполнения огромного количества функций базовых DLL системы. Подобная технология была названа «Наборами API» (API Sets), появилась в Windows 7 и предназначалась для группировки всех [многочисленных] функций в 34 различных типа и уровня выполнения, с целью предотвратить циклические зависимости между модулями и минимизировать проблемы с производительностью, которые обусловлены обеспечением зависимости новых DLL от набора Win32 API в адресном пространстве процесса. Перенаправляет вызовы, адресованные базовым DLL к их новым копиям, разделенным на уровни.
00050000
Стек потока
[64-битный] стек потока.
00090000
Стек потока.
Одномерный массив элементов с упорядоченными адресами (организованный по принципу «последний пришел — первым ушел» (LIFO)), предназначенный для хранения небольших объемов данных фиксированного размера (слово/двойное слово/четверное слово): стековых фреймов, передаваемых в функцию аргументов, локальных переменных функций, временно сохраняемых значений регистров. Для каждого потока выделяется собственный (отдельный) стек. Каждый раз при создании нового потока в контексте процесса, система резервирует регион адресного пространства для стека потока и передает данному региону определенный объем [физической] памяти. Для стека система резервирует 1024Кб (1Мб) адресного пространства и передает ему всего две страницы (2х8Кб?) памяти. Но перед фактическим выполнением потока система устанавливает указатель стека на конец верхней страницы региона стека, это именно та страница, с которой поток начнет использовать свой стек. Вторая страница сверху называется сторожевой (guard page). Как только активная страница «переполняется», поток вынужден обратиться к следующей (сторожевой) странице. В этом случае система уведомляется о данном факте и передает память еще одной странице, расположенной непосредственно за сторожевой. После чего флаг PAGE_GUARD переходит к странице, которой только что была передана память. Благодаря описанному механизму объем памяти стека увеличивается исключительно по мере необходимости.
00280000
msctf.dll.mui
Файл локализации библиотеки msctf.dll , описанной ниже. В общем смысле представляет собой переведенные на русский язык текстовые строки/константы, используемые библиотекой.
00400000
test2.exe
Собственно образ нашей программы. Отображается в виртуальном адресном пространстве благодаря системному механизму проецирования файлов. Исполняемый .exe-файл проецируется на адресное пространство программы по определенным адресам и становится его частью. Проецирование состоит в том, что данные [из файла] не копируются в память, а как бы связываются с данными на физическом носителе, то есть любое обращение к памяти по этим адресам инициирует чтение данных с диска, память как бы «читается» из файла на диске. Виртуальный адрес 00400000 является «предпочитаемой базой образа» (Image base), константой, которую можно изменять при компиляции. По традиции, никто этим не заморачивается, и, в большинстве случаев, данный адрес актуален для подавляющего большинства программ (но встречаются и исключения).
Представляет из себя программную среду, позволяющую исполнять 32-разрядные приложения на 64-разрядной версии Windows. Механизм используется в 64-разрядных версиях Windows в виде набора библиотек DLL пользовательского режима. Помимо данных библиотек в 64-разрядной версии ОС присутствует поддержка со стороны ядра (изменение контекста). Перехватывает системные вызовы 32-битных версий ntdll.dll и user32.dll , поступающих от 32-битных приложений и транслирует их в 64-битные вызовы ядра. С помощью Wow64 создаются 32-разрядные версии структур данных для процесса, например PEB , TEB и другие, на основе их 64-разрядных прототипов.
Обеспечивает инфраструктуру эмуляции (преобразования) системных вызовов, экспортируемых ядром ntoskrnl.exe. По сути, организует перенаправление всего основного функционала, включающего операции с файловой системой и реестром. Управляет созданием процесса и потоков в нём.
wow64cpu.dll
Библиотека, отвечающая за эмуляцию x86-инструкций на процессорах Itanium. Управляет 32-разрядным контекстом процессора для каждого потока, запущенного в рамках Wow64. Поддерживает переключение режима работы с 32-разрядного в 64-разрядный и наоборот, обеспечивая поддержку всей логики. Не обязательна для x64-процессоров, поскольку они выполняют x86-32-инструкции напрямую.
Выводы
К каким выводам можно придти после изучения адресного пространства процесса? Первый состоит в том, что понятие «памяти» для пользовательских программ это достаточно условное обозначение, поскольку регионы адресного пространства могут по разному отображаться на различные объекты операционной системы. Второй состоит в том, что адресное пространство процесса это огромный линейный массив байтов, в котором хранится всё, с чем непосредственно работает процесс (программа). Массив этот виртуален, не ограничен физической памятью, уникален для каждого приложения и обладает достаточной размерностью, дабы программист не задумывался о его ограничениях. Механизм создания адресного пространства процесса достаточно сложен, и в статье удалось рассмотреть лишь малую часть его логики. В добавок, мы вовсе не касались 64-битных реалий, грозно смотрящих на нас из недалекого будущего 🙂 но, пожалуй это тема отдельной статьи.
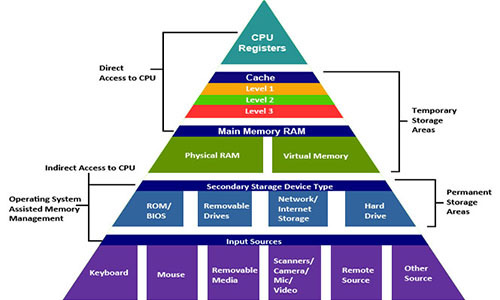


 HDD
 SSD
 struchkov.dev Struchkov Mark